前置知识:前缀函数与 KMP 算法.
KMP 算法将前缀匹配的信息用到了极致,
而 BM 算法背后的基本思想是通过后缀匹配获得比前缀匹配更多的信息来实现更快的字符跳转.
引入
想象一下,如果我们的模式字符串 ,被放在文本字符串 的左手起头部,使它们的第一个字符对齐.
在这里做定义,往后不赘述:
的长度为 ,特别地对于从 0 开始的串来说,规定 为 串最后一个字符的位置;
的长度 ,.
假如我们知道了 的第 个字符 (与 的最后一个字符对齐)考虑我们能得到什么信息:
观察 1
如果我们知道 这个字符不在 中,我们就不用考虑 从 的第 个、第 个……第 个字符起出现的情况,而可以直接将 向下滑动 个字符.
观察 2
更一般地,如果出现在 最末尾(也就是最右边)的那一个 字符的位置是离末尾端差了 个字符,
那么就可以不用匹配,直接将 向后滑动 个字符:如果滑动距离少于 ,那么仅就 这个字符就无法被匹配,当然模式字符串 也就不会被匹配.
因此除非 字符可以和 末尾的那个字符匹配,否则 要跳过 个字符(相当于 向后滑动了 个字符).并且我们可以得到一个计算 的函数 :
需要注意,显然这个表只需计算到 的位置.
现在假设 和 最后一个字符匹配到了,那我们就看看 前一个字符和 的倒数第二个字符是否匹配:
如果是,就继续回退直到整个模式串 完成匹配(这时我们就在 上成功得到了一个 的匹配);
或者,我们也可能会在匹配完 的倒数第 个字符后,在倒数第 个字符上失配,这时我们就希望把 向后滑动到下一个可能会实现匹配的位置,当然我们希望滑动得越远越好.
观察 3(a)
在 观察 2 中提到,当匹配完 的倒数 个字符后,如果在倒数第 个字符失配,为了使得 中的失配字符与 上对应字符对齐,
需要把 向后滑动 个字符,也就是说我们应该把注意力看向之后的 个字符(也就是看向 滑动 k 之后,末段与 对齐的那个字符).
而 ,
所以我们的注意力应该沿着 向后跳 个字符.
然而,我们有机会跳过更多的字符,请继续看下去.
观察 3(b)
如果我们知道 接下来的 个字符和 的最后 个字符匹配,假设这个子串为 ,
我们还知道在 失配字符 后面是与 相匹配的子串,而假如 对应失配字符前面存在 ,我们可以将 向下滑动一段距离,
使得失配字符 在 上对应的字符前面出现的 (合理重现,plausible reoccurrence,以下也简称 pr)与 的 对齐.如果 上有多个 ,按照从右到左的后缀匹配顺序,取第一个(rightmost plausible reoccurrence,以下也简称 rpr).
假设此时 向下滑动的 个字符(也即 末尾端的 与其最右边的合理重现的距离),这样我们的注意力应该沿着 向后滑动 个字符,这段距离我们称之为 :
假定 为 在 上失配时的最右边合理重现的位置,(这里只给出简单定义,在下文的算法设计章节里会有更精确的讨论),那么显然 .
所以有:
于是我们在失配时,可以把 上的注意力往后跳过 个字符
过程
箭头指向失配字符 :
没有出现 中,根据 观察 1, 直接向下移动 个字符,也就是 7 个字符:
根据 观察 2,我们需要将 向下移动 4 个字符使得短横线字符对齐:
现在char: 匹配了,把 上的指针左移一步继续匹配:
根据 观察 3(a), 失配,因为 不在 中,所以 向下移动 个字符,而 上指针向下移动 个字符:
这时 又一次匹配到了 的最后一个字符 , 上的指针向左匹配,匹配到了 ,继续向左匹配,发现在字符 失配:
显然直观上看,此时根据 观察 3(b),将 向下移动 个字符,使得后缀 对齐,这种滑动可以获得 指针最大的滑动距离,此时 ,即 上指针向下滑动 7 个字符.
而从形式化逻辑看,此时,, 这样从形式逻辑上支持了进行 观察 3(b) 的跳转:
现在我们发现了 上每一个字符都和 上对应的字符相等,我们在 上找到了一个 的匹配.而只花费了 14 次对 的引用,其中 7 次是完成一个成功的匹配所必需的比较次数(),另外 7 次让我们跳过了 22 个字符.
算法设计
最初的匹配算法
解释
现在看这样一个利用 和 进行字符串匹配的算法:
如果上面的算法 ,表明 不在 中;如果返回一个数字,表示 在 左起第一次出现的位置.
然后让我们更精细地描述下计算 ,所依靠的 函数.
根据前文定义, 表示在 失配时,子串 在 最右边合理重现的位置.
也就是说需要找到一个最好的 , 使得 ,另外要考虑两种特殊情况:
- 当 时,相当于在 前面补充了一段虚拟的前缀,实际上也符合 跳转的原理.
- 当 时,如果 ,则这个 不能作为 的合理重现. 原因是 本身是失配字符,所以 向下滑动 个字符后,在后缀匹配过程中仍然会在 处失配.
还要注意两个限制条件:
- .因为当 时,有 ,在 上失配的字符也会在 上失配.
- 考虑到 ,所以规定 .
过程
由于理解 是实现 BoyerMoore 算法的核心,所以我们使用如下两个例子进行详细说明:
对于 , 为 ,在 之前的最右边合理重现只能是 ,也就是最右边合理重现位置为 -5,即 ;
对于 , 为 ,在 之前的最右边的合理重现是 ,所以 ;
对于 , 为 ,在 之前的最右边的合理重现是 ,所以 ;
对于 , 为 ,在 之前的最右边的合理重现是 ,所以 ;
对于 , 为 ,在 之前的最右边的合理重现是 ,所以 ;
对于 , 为 ,在 之前的最右边的合理重现是 ,所以 ;
对于 , 为 ,又因为 ,即 等于失配字符 ,所以 并不是符合条件的 的合理重现,所以在最右边的合理重现是 ,所以 ;
对于 , 为 ,同理又因为 ,所以 并不是符合条件的 的合理重现,在最右边的合理重现是 ,所以 ;
对于 ,根据 定义,,得到 .
现在再看一下另一个例子:
对于 , 为 ,在 之前的最右边合理重现只能是 ,也就是最右边合理重现位置为 -8,即 ;
对于 , 为 ,在 之前的最右边合理重现只能是 ,;
对于 , 为 ,在 之前的最右边合理重现只能是 ,;
对于 , 为 ,在 之前的最右边合理重现只能是 ,;
对于 , 为 ,在 之前的最右边合理重现只能是 ,;
对于 , 为 ,在 之前的最右边合理重现只能是 ,;
对于 , 为 ,因为 并且有 ,所以在 之前的最右边的合理重现是 ,;
对于 , 为 ,虽然 但是因为 ,所以在 之前的最右边的合理重现是 ,;
对于 ,根据 定义,,得到 .
对匹配算法的一个改进
最后,实践过程中考虑到搜索过程中估计有 80% 的时间用在了 观察 1 的跳转上,也就是 和 不匹配,然后跳跃整个 进行下一次匹配的过程.
于是,可以为此进行特别的优化:
我们定义一个 :
用 代替 ,得到改进后的匹配算法:
其中 起到多重作用,一是类似后面介绍的 Horspool 算法进行快速的坏字符跳转,二是辅助检测字符串搜索是否完成.
经过改进,比起原算法,在做 观察 1 跳转时不必每次进行 的多余计算,使得在通常字符集下搜索字符串的性能有了明显的提升.
delta2 构建细节
引入
在 1977 年 10 月的Communications of the ACM上,Boyer、Moor 的论文1中只描述了 静态表,
构造 的具体实现的讨论出现在 1977 年 6 月 Knuth、Morris、Pratt 在SIAM Journal on Computing上正式联合发表的 KMP 算法的论文2.
朴素算法
在介绍 Knuth 的 构建算法之前,根据定义,我们会有一个适用于小规模问题的朴素算法:
- 对于
[0, patlen)区间的每一个位置i,根据subpat的长度确定其重现位置的区间,也就是[-subpatlen, i]; - 可能的重现位置按照从右到左进行逐字符比较,寻找符合 要求的最右边 的重现位置;
- 最后别忘了令 .
实现
use std::cmp::PartialEq;

pub fn build_delta_2_table_naive(p: &[impl PartialEq]) -> Vec<usize> {
    let patlen = p.len();
    let lastpos = patlen - 1;
    let mut delta_2 = vec![];

    for i in 0..patlen {
        let subpatlen = (lastpos - i) as isize;

        if subpatlen == 0 {
            delta_2.push(0);
            break;
        }

        for j in (-subpatlen..(i + 1) as isize).rev() {
            // subpat 匹配
            if (j..j + subpatlen)
            .zip(i + 1..patlen)
            .all(|(rpr_index, subpat_index)| {
                if rpr_index < 0 {
                    return true;
                }

                if p[rpr_index as usize] == p[subpat_index] {
                    return true;
                }

                false
            })
            && (j <= 0 || p[(j - 1) as usize] != p[i])
            {
                delta_2.push((lastpos as isize - j) as usize);
                break;
            }
        }
    }

    delta_2
}
特别地,对 Rust 语言特性进行必要地解释,下不赘述:
usize和isize是和内存指针同字节数的无符号整数和有符号整数,在 32 位机上相当于u32和i32,64 位机上相当于u64和i64.- 索引数组、向量、分片时使用
usize类型的数字(因为在做内存上的随机访问并且下标不能为负值),所以如果需要处理负值要用isize,而进行索引时又要用usize,这就看到使用as关键字进行二者之间的显式转换. impl PartialEq只是用作泛型,可以同时支持Unicode编码的char和二进制的u8.
显然,该暴力算法的时间复杂度为 .
高效算法
下面我们要介绍的是时间复杂度为 ,但是需要额外 空间复杂度的高效算法.
虽然 1977 年 Knuth 提出了这个构建方法,然而他的原始版本的构建算法存在一个缺陷,实际上对于某些 产生不出符合定义的 .
Rytter 在 1980 年SIAM Journal on Computing上发表的文章3对此提出了修正,以下是 的构建算法:
首先考虑到 的定义比较复杂,我们按照 的重现位置进行分类,每一类进行单独处理,这是高效实现的关键思路.
按照重现位置由远到近,也就是偏移量由大到小,分成如下几类:
-
整个 重现位置完全在 左边的,比如 ,此时 ;
-
的重现有一部分在 左边,有一部分是 头部,比如 ,此时 ; 我们把 完全在 头部的边际情况也归类在这里(当然根据实现也可以归类在下边),比如 ,此时 ;
-
的重现完全在 中,比如 ,此时 .
现在来讨论如何高效地计算这三种情况:
第一种情况
这是最简单的情况,只需一次遍历并且可以顺便将 初始化.
第二种情况
我们观察什么时候会出现 的重现一部分在 左边,一部分是 的头部的情况呢?应该是 的某个后缀和 的某个前缀相等,
比如之前的例子:
的重现 , 的后缀与 pat 前缀中,有相等的,是 .
实际上,对第二种和第三种情况的计算的关键都需要前缀函数的计算和和应用.
那么只要 取值使得 包含这个相等的后缀,那么就可以得到第二种情况的 的重现,对于例子,我们只需要使得 ,
而当 时,就是 完全在 头部的边际情况.
可以计算此时的 :
设此时这对相等的前后缀长度为 ,可知 ,那么在 左边的部分长度是 ,
而 ,所以得到 .
其后面可能会有多对相等的前缀和后缀,比如:
在 处有 , 处有 ,在 处有
Knuth 算法的缺陷是只考虑了最长的那一对的情况,但实际上我们要考虑所有 后缀与 前缀相等的情况,等同于计算 所有真后缀和真前缀相等的情况,并按照长度从大到小, 分区间计算不同的 .
利用前缀函数和逆向运用计算前缀函数的状态转移方程:,以得到 所有相等的真前缀和真后缀长度.从 开始作为最长一对的长度,然后通过逆向运行状态转移方程,得到下一个次长相等真前缀和真后缀的长度.
如此就完成了第二种情况的 的计算.
第三种情况
的重现恰好就在 中(不包括 的头部),也就是按照从右到左的顺序,在 中寻找 .
如果用 BM 算法解决,我们就得到了一个 BM 的递归实现的第三种情况,结束条件是 .
而且根据 的定义,找到的 的重现的下一个(也就是左边一个)字符和作为 后缀的 的下一个字符不能一样.
这就很好地启发了我们,可以使用类似于计算前缀函数的过程计算第三种情况,只不过是左右反过来的前缀函数:
- 两个指针分别指向子串的左端点和子串最长公共前后缀的「前缀」位置,从右向左移动,在发现指向的两个字符相等时继续移动,此时相当于「前缀」变大;
- 当两个字符不相等时,之前相等的部分就满足了 对重现的要求,并且回退指向「前缀」位置的指针直到构成新的字符相等或者出界.
同前缀函数一样,需要一个辅助数组,用于回退,可以使用之前计算第二种情况所生成的前缀数组的空间.
实现
上述实现
use std::cmp::PartialEq;
use std::cmp::min;

pub fn build_delta_2_table_improved_minghu6(p: &[impl PartialEq]) -> Vec<usize> {
    let patlen = p.len();
    let lastpos = patlen - 1;
    let mut delta_2 = Vec::with_capacity(patlen);

    // 第一种情况
    // delta_2[j] = lastpos * 2 - j
    for i in 0..patlen {
        delta_2.push(lastpos * 2 - i);
    }

    // 第二种情况
    // lastpos <= delata2[j] = lastpos * 2 - j
    let pi = compute_pi(p);  // 计算前缀函数
    let mut i = lastpos;
    let mut last_i = lastpos; // 只是为了初始化
    while pi[i] > 0 {
        let start;
        let end;

        if i == lastpos {
            start = 0;
        } else {
            start = patlen - pi[last_i];
        }

        end = patlen - pi[i];

        for j in start..end {
            delta_2[j] = lastpos * 2 - j - pi[i];
        }

        last_i = i;
        i = pi[i] - 1;
    }

    // 第三种情况
    // delata2[j] < lastpos
    let mut j = lastpos;
    let mut t = patlen;
    let mut f = pi;
    loop {
        f[j] = t;
        while t < patlen && p[j] != p[t] {
            // 使用min函数保证后面可能的回退不会覆盖前面的数据
            delta_2[t] = min(delta_2[t], lastpos - 1 - j);
            t = f[t];
        }

        t -= 1;
        if j == 0 {
            break;
        }
        j -= 1;
    }

    // 没有实际意义,只是为了完整定义
    delta_2[lastpos] = 0;

    delta_2
}
Galil 规则对多次匹配时最坏情况的改善
关于后缀匹配算法的多次匹配问题
之前的搜索算法只涉及到在 中寻找第一次 匹配的情况,而对与在 中寻找全部 的匹配的情况有很多不同的算法思路,这个问题的核心关注点是:如何利用之前匹配成功的字符的信息,将最坏情况下的时间复杂度降为线性.
在原始的成功匹配后,简单的 的指针向后滑动 距离后重新开始后缀匹配,这会导致最坏情况下回到 的时间复杂度(按照惯例, 为 , 为 ,下同).
比如一个极端的例子::,:.
对此 Knuth 提出来的一个方法是用一个「数量有限」的状态的集合来记录 长度的字符,这种算法保证 上每一个字符最多比较一次,但代价是这个「数量有限」的状态可能规模并不小,对于一个字符彼此不相等的 ,需要 个状态.
下面介绍的思路简单且不需要额外预处理开销的 Galil 算法4.
Galil 规则
假定一个 ,它是某个子串 重复 n 次构成的字符串 的前缀,那么我们称 为 的一个周期.
比如,,是 的重复 的前缀,所以 的长度 就是这个 的周期长度,也即 满足 .
至少拥有一个长度为它自身的周期,我们规定最短的周期为 ,.
在搜索过程中,假如我们的 成功地完成了一次匹配,那么依照周期的特点,实际上只需将 向后滑动 个字符,比较这 个字符是否对应相等就可以直接判断是否存在 的又一个匹配.
为计算这个最短周期的长度,我们假设已知 的相等的一对前缀 - 后缀,设它们的长度为 ,那么有 .从而得到长度为 的周期,
当我们知道 最长的那一对相等的前缀 - 后缀,我们就得到了 最短的周期.
而最长相等的前后缀长度,,已经在我们在计算 的过程中,所以实际不需要额外的预处理时间和空间,就能将后缀匹配算法最坏情况的时间复杂度改善成线性.
结合上述优化的 BM 的搜索算法最终实现
#[cfg(target_pointer_width = "64")]
const LARGE: usize = 10_000_000_000_000_000_000;

#[cfg(not(target_pointer_width = "64"))]
const LARGE: usize = 2_000_000_000;

pub struct BMPattern<'a> {
    pat_bytes: &'a [u8],
    delta_1: [usize; 256],
    delta_2: Vec<usize>,
    k: usize  // pat的最短周期长度
}

impl<'a> BMPattern<'a> {
    // ...

    pub fn find_all(&self, string: &str) -> Vec<usize> {
        let mut result = vec![];
        let string_bytes = string.as_bytes();
        let stringlen = string_bytes.len();
        let patlen = self.pat_bytes.len();
        let pat_last_pos = patlen - 1;
        let mut string_index = pat_last_pos;
        let mut pat_index;
        let l0 =  patlen - self.k;
        let mut l = 0;

        while string_index < stringlen {
            let old_string_index = string_index;

            while string_index < stringlen {
                string_index += self.delta0(string_bytes[string_index]);
            }
            if string_index < LARGE {
                break;
            }

            string_index -= LARGE;

            // 如果string_index发生移动,意味着自从上次成功匹配后发生了至少一次的失败匹配.
            // 此时需要将Galil规则的二次匹配的偏移量归零.
            if old_string_index < string_index {
                l = 0;
            }

            pat_index = pat_last_pos;

            while pat_index > l && string_bytes[string_index] == self.pat_bytes[pat_index] {
                string_index -= 1;
                pat_index -= 1;
            }

            if pat_index == l && string_bytes[string_index] == self.pat_bytes[pat_index] {
                result.push(string_index - l);

                string_index += pat_last_pos - l + self.k;
                l = l0;
            } else {
                l = 0;
                string_index += max(
                    self.delta_1[string_bytes[string_index] as usize],
                    self.delta_2[pat_index],
                );
            }
        }

        result
    }
}
最坏情况在实践中性能影响
从实践的角度上说,理论上的最坏情况并不容易影响性能表现,哪怕是很小的只有 4 的字符集的随机文本测试下这种最坏情况的影响也小到难以观察.
也因此如果没有很好地设计,使用 Galil 法则会拖累一点平均的性能表现,但对于一些极端特殊的 和 比如例子中的::,:,Galil 规则的应用确实会使得性能表现提高数倍.
改进算法
Simplified Boyer–Moore 算法
BM 算法最复杂的地方就在于 表(也就是好后缀表)的构建,而实践中发现,在一般的字符集上的匹配性能主要依靠 表(也就是坏字符表),于是出现了仅仅使用 表的简化版 BM 算法,通常性能和原版差距很小.
Boyer–Moore–Horspol 算法
Horspol 算法同样是基于坏字符的规则,在与 尾部对齐的字符上应用 .效果类似于对原版匹配算法的改进,通常性能优于原版本.
实现
pub struct HorspoolPattern<'a> {
    pat_bytes: &'a [u8],
    bm_bc: [usize; 256],
}

impl<'a> HorspoolPattern<'a> {
    // ...
    pub fn find_all(&self, string: &str) -> Vec<usize> {
        let mut result = vec![];
        let string_bytes = string.as_bytes();
        let stringlen = string_bytes.len();
        let pat_last_pos = self.pat_bytes.len() - 1;
        let mut string_index = pat_last_pos;

        while string_index < stringlen {
            if &string_bytes[string_index-pat_last_pos..string_index+1] == self.pat_bytes {
                result.push(string_index-pat_last_pos);
            }

            string_index += self.bm_bc[string_bytes[string_index] as usize];
        }

        result
    }
}
Boyer–Moore–Sunday 算法
Sunday 算法同样是利用坏字符规则,只不过相比 Horspool 它更进一步,直接关注 尾部对齐的那个字符的下一个字符.
实现它只需要稍微修改 表,相当于在 长度的 上进行构建.
Sunday 算法通常用作一般情况下实现最简单而且平均表现最好之一的实用算法,通常性能比 Horspool 和 BM 要好一点.
实现
pub struct SundayPattern<'a> {
    pat_bytes: &'a [u8],
    sunday_bc: [usize; 256],
}

impl<'a> SundayPattern<'a> {
    // ...
    fn build_sunday_bc(p: &'a [u8]) -> [usize; 256] {
        let mut sunday_bc_table = [p.len() + 1; 256];

        for i in 0..p.len() {
            sunday_bc_table[p[i] as usize] = p.len() - i;
        }

        sunday_bc_table
    }

    pub fn find_all(&self, string: &str) -> Vec<usize> {
        let mut result = vec![];
        let string_bytes = string.as_bytes();
        let pat_last_pos = self.pat_bytes.len() - 1;
        let stringlen = string_bytes.len();
        let mut string_index = pat_last_pos;

        while string_index < stringlen {
            if &string_bytes[string_index - pat_last_pos..string_index+1] == self.pat_bytes {
                result.push(string_index - pat_last_pos);
            }

            if string_index + 1 == stringlen {
                break;
            }

            string_index += self.sunday_bc[string_bytes[string_index + 1] as usize];
        }

        result
    }
}
BMHBNFS 算法
该算法结合了 Horspool 和 Sunday,是 CPython 实现 stringlib 模块时用到的 find 的算法5,以下简称 B5S.
B5S 基本思路是:
-
按照后缀匹配的思路,首先比较 位置对应的字符是否相等,如果相等就比较 对应位置的字符是否相等,如果仍然相等,那么就发现一个匹配;
-
如果任何一个阶段发生不匹配,就进入跳转阶段;
-
在跳转阶段,首先观察 位置的下一个字符是否在 中,如果不在,直接向右滑动 ,这是 Sunday 算法的最大利用;
如果这个字符在 中,对 处的字符利用 进行 Horspool 跳转.
而根据时间节省还是空间节省为第一目标,算法会有差别巨大的不同实现.
时间节省版本
实现
pub struct B5STimePattern<'a> {
    pat_bytes: &'a [u8],
    alphabet: [bool;256],
    bm_bc: [usize;256],
    k: usize
}

impl<'a> B5STimePattern<'a> {
    pub fn new(pat: &'a str) -> Self {
        assert_ne!(pat.len(), 0);

        let pat_bytes = pat.as_bytes();
        let (alphabet, bm_bc, k) = B5STimePattern::build(pat_bytes);

        B5STimePattern { pat_bytes, alphabet, bm_bc, k }
    }

    fn build(p: &'a [u8]) -> ([bool;256], [usize;256], usize)  {
        let mut alphabet = [false;256];
        let mut bm_bc = [p.len(); 256];
        let lastpos = p.len() - 1;

        for i in 0..lastpos {
            alphabet[p[i] as usize] = true;
            bm_bc[p[i] as usize] = lastpos - i;
        }

        alphabet[p[lastpos] as usize] = true;

        (alphabet, bm_bc, compute_k(p))
    }

    pub fn find_all(&self, string: &str) -> Vec<usize> {
        let mut result = vec![];
        let string_bytes = string.as_bytes();
        let pat_last_pos = self.pat_bytes.len() - 1;
        let patlen = self.pat_bytes.len();
        let stringlen = string_bytes.len();
        let mut string_index = pat_last_pos;
        let mut offset = pat_last_pos;
        let offset0 = self.k - 1;

        while string_index < stringlen {
            if string_bytes[string_index] == self.pat_bytes[pat_last_pos] {
                if &string_bytes[string_index-offset..string_index] == &self.pat_bytes[pat_last_pos-offset..pat_last_pos] {
                    result.push(string_index-pat_last_pos);

                    offset = offset0;

                    // Galil rule
                    string_index += self.k;
                    continue;
                }
            }

            if string_index + 1 == stringlen {
                break;
            }

            offset = pat_last_pos;

            if !self.alphabet[string_bytes[string_index+1] as usize] {
                string_index += patlen + 1;  // sunday
            } else {
                string_index += self.bm_bc[string_bytes[string_index] as usize];  // horspool
            }
        }

        result
    }
}
该版本的 B5S 性能表现非常理想,在目前介绍的后缀匹配系列算法中是通常情况下是最快的.
空间节省版本
同样在 CPython stringlib 中实现,使用了两个整数近似取代了字符表和 的作用,极大地节省了空间:
-
用一个简单的 Bloom 过滤器取代字符表(alphabet)
???+ note "实现" ```rust pub struct BytesBloomFilter { mask: u64, }
impl BytesBloomFilter {
    pub fn new() -> Self {
        SimpleBloomFilter {
            mask: 0,
        }
    }

    fn insert(&mut self, byte: &u8) {
        (self.mask) |= 1u64 << (byte & 63);
    }

    fn contains(&self, char: &u8) -> bool {
        (self.mask & (1u64 << (byte & 63))) != 0
    }
}
```
Bloom 过滤器设设计通过牺牲准确率(实际还有运行时间)来极大地节省存储空间的
Set类型的数据结构,它的特点是会将集合中不存在的项误判为存在(False Positives,简称 FP),但不会把集合中存在的项判断为不存在(False Negatives,简称 FN),因此使用它可能会因为 FP 而没有得到最大的字符跳转,但不会因为 FN 而跳过本应匹配的字符.理论上分析,上述「Bloom 过滤器」的实现在 长度在 50 个 Bytes 时,FP 概率约为 0.5,而 长度在 10 个 Bytes 时,FP 概率约为 0.15.
虽然这不是一个标准的 Bloom 过滤器,首先它实际上没有使用一个真正的哈希函数,实际上它只是一个字符映射,将 0-255 的字节映射为它的前六位构成的数.
但考虑到我们在内存上的进行字符搜索,这种简化就非常重要,即使用目前已知最快的非加密哈希算法 xxHash,计算所需要的时间仍比它高一个数量级.
另外当 pat 在 30 字节以下时,为了达到最佳的 FP 概率,需要不止一个哈希函数.但这么做意义不大,因为用装有两个
u128数字的数组就已经可以构建字符表的全字符集. -
使用 代替整个
观察 ,最常使用处就是后缀匹配时第一个字符就不匹配是最常见的不匹配的情况,于是令
skip = delta1(pat[patlastpos]),在第一阶段不匹配时,直接向下滑动
skip个字符;但当第二阶段不配时,因为缺乏整个 的信息,只能向下滑动一个字符.???+ note "实现" ```rust pub struct B5SSpacePattern<'a> { pat_bytes: &'a [u8], alphabet: BytesBloomFilter, skip: usize, }
impl<'a> B5SSpacePattern<'a> {
    pub fn new(pat: &'a str) -> Self {
        assert_ne!(pat.len(), 0);

        let pat_bytes = pat.as_bytes();
        let (alphabet, skip) = B5SSpacePattern::build(pat_bytes);

        B5SSpacePattern { pat_bytes, alphabet, skip}
    }

    fn build(p: &'a [u8]) -> (BytesBloomFilter, usize)  {
        let mut alphabet = BytesBloomFilter::new();
        let lastpos = p.len() - 1;
        let mut skip = p.len();

        for i in 0..p.len()-1 {
            alphabet.insert(&p[i]);

            if p[i] == p[lastpos] {
                skip = lastpos - i;
            }
        }

        alphabet.insert(&p[lastpos]);

        (alphabet, skip)
    }

    pub fn find_all(&self, string: &'a str) -> Vec<usize> {
        let mut result = vec![];
        let string_bytes = string.as_bytes();
        let pat_last_pos = self.pat_bytes.len() - 1;
        let patlen = self.pat_bytes.len();
        let stringlen = string_bytes.len();
        let mut string_index = pat_last_pos;

        while string_index < stringlen {
            if string_bytes[string_index] == self.pat_bytes[pat_last_pos] {
                if &string_bytes[string_index-pat_last_pos..string_index] == &self.pat_bytes[..patlen-1] {
                    result.push(string_index-pat_last_pos);
                }

                if string_index + 1 == stringlen {
                    break;
                }

                if !self.alphabet.contains(&string_bytes[string_index+1]) {
                    string_index += patlen + 1;  // sunday
                } else {
                    string_index += self.skip;  // horspool
                }
            } else {
                if string_index + 1 == stringlen {
                    break;
                }

                if !self.alphabet.contains(&string_bytes[string_index+1]) {
                    string_index += patlen + 1;  // sunday
                } else {
                    string_index += 1;
                }
            }

        }

        result
    }
}
```
这个版本的算法相较于前面的后缀匹配算法不够快,但差距不大,性能仍然优于 KMP,得益于它至多两个
u64的整数的优秀空间复杂度.
理论分析
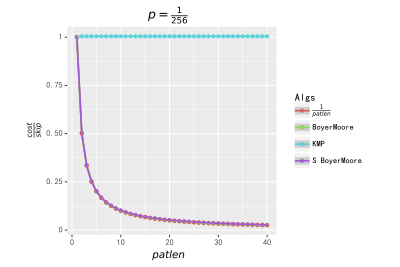
以下是一般字符集下各算法的表现,纵坐标类似于执行开销(cost 指匹配成功 m 个字符后失配时的代价,skip 指发生失配时向下滑动 k 个字符的概率),越小性能越好.横坐标为模式字符串 pat 的长度:
在较小字符集(DNA {A, C, T, G} 碱基对序列)中的表现:
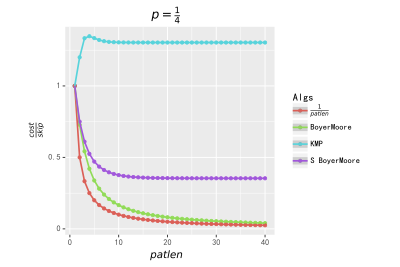
综上,在较大的字符集,比如日常搜索的过程中,BoyerMoore 系列算法的优越表现,其中主要依赖 表实现字符跳转;
另一方面,在较小的字符集里, 的作用下降,而 的作用得到了体现.
如果有一定富裕空间的情况下,完整的空间复杂度为 的 BoyerMoore 算法更加通用,综合表现最优.