引入
线性规划(linear programming, LP)是研究线性约束条件下线性目标函数最值问题的方法总称,是运筹学的一个分支,在多方面均有应用.线性规划的某些特殊情况,如网络流、多商品流量等问题都有可能在算法竞赛题目中出现.算法竞赛很少会出现只能用线性规划算法解决的问题,绝大多数这类问题可以通过网络流建模等方法更高效地解决.
一个简单的例子
一个问题能够写成线性规划的形式,既要有若干个线性约束条件,又要有线性的目标函数.
考虑下面的例子:
例子
早点师傅每天可以制作一定数量的包子和油条,这两种早餐深受顾客喜爱.为了最大化利润,师傅希望尽可能多地制作早点,但在实际操作中受到食材、时间等多种资源的限制.为此,师傅统计了制作每份早点所需的食材用量、制作时间及其对应的利润,具体如下表所示:
早点 植物油 面粉 时间 利润 包子 4 4 4 7 7 7 8 8 8 5 5 5 油条 7 7 7 3 3 3 6 6 6 6 6 6
假设师傅每天最多可以购入 66 66 66 60 60 60 96 96 96
用数学语言描述,可以设 x 1 x_1 x 1 x 2 x_2 x 2 66 66 66
4 x 1 + 7 x 2 ≤ 66. 4x_1 + 7x_2 \le 66. 4 x 1 + 7 x 2 ≤ 66. 类似地,「总共需要的面粉不超过 60 60 60 96 96 96
7 x 1 + 3 x 2 ≤ 60 , 8 x 1 + 6 x 2 ≤ 96. \begin{aligned}
7x_1 + 3x_2 &\le 60,\\
8x_1 + 6x_2 &\le 96.
\end{aligned} 7 x 1 + 3 x 2 8 x 1 + 6 x 2 ≤ 60 , ≤ 96. 另外,师傅不可能生产出负数单位的早点,所以,还有条件
x 1 , x 2 ≥ 0. x_1,x_2\ge 0. x 1 , x 2 ≥ 0. 师傅就是要在这些限制下,最大化利润:
z = 5 x 1 + 6 x 2 . z = 5x_1 + 6x_2. z = 5 x 1 + 6 x 2 . 这就是一个典型的线性规划问题.它的目标函数是关于决策变量的线性函数,约束条件则由决策变量构成的线性等式或不等式组成.
图解法
对于只有两个决策变量的线性规划问题,可以通过图解法直观地解决问题.
考虑本节的问题
max x 1 , x 2 z = 5 x 1 + 6 x 2 subject to 4 x 1 + 7 x 2 ≤ 66 , 7 x 1 + 3 x 2 ≤ 60 , 8 x 1 + 6 x 2 ≤ 96 , x 1 , x 2 ≥ 0 \begin{aligned}
\max_{x_1,x_2}\;& z = 5x_1 + 6x_2 \\
\text{subject to } & 4x_1 + 7x_2 \le 66,\\
& 7x_1 + 3x_2 \le 60,\\
& 8x_1 + 6x_2 \le 96,\\
& x_1,x_2\ge 0
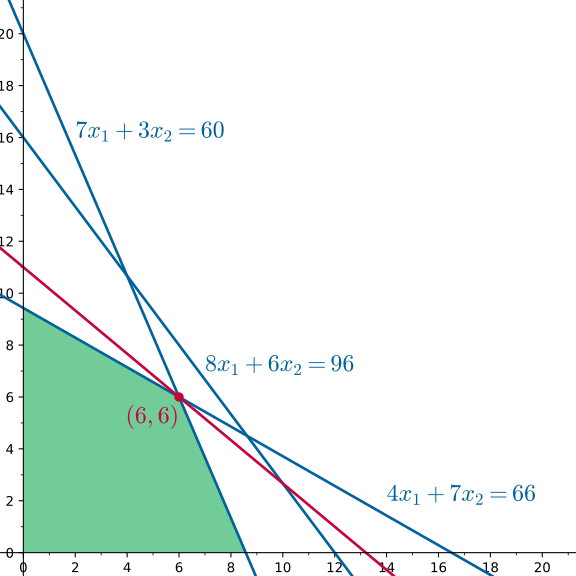
\end{aligned} x 1 , x 2 max subject to z = 5 x 1 + 6 x 2 4 x 1 + 7 x 2 ≤ 66 , 7 x 1 + 3 x 2 ≤ 60 , 8 x 1 + 6 x 2 ≤ 96 , x 1 , x 2 ≥ 0 对应的几何图像.最后一行约束表示可选的点 ( x 1 , x 2 ) (x_1,x_2) ( x 1 , x 2 ) 4 x 1 + 7 x 2 = 66 4x_1 + 7x_2 = 66 4 x 1 + 7 x 2 = 66 7 x 1 + 3 x 2 = 60 7x_1 + 3x_2 = 60 7 x 1 + 3 x 2 = 60 8 x 1 + 6 x 2 = 96 8x_1 + 6x_2 = 96 8 x 1 + 6 x 2 = 96
接下来要最大化 z = 5 x 1 + 6 x 2 z=5x_1+6x_2 z = 5 x 1 + 6 x 2 5 x 1 + 6 x 2 = z 5x_1+6x_2=z 5 x 1 + 6 x 2 = z z z z z z z z z z
如图所示,这样的情形发生在红点所示位置.它是直线 4 x 1 + 7 x 2 = 66 4x_1 + 7x_2 = 66 4 x 1 + 7 x 2 = 66 7 x 1 + 3 x 2 = 60 7x_1 + 3x_2 = 60 7 x 1 + 3 x 2 = 60 ( 6 , 6 ) (6,6) ( 6 , 6 ) z = 66 z=66 z = 66
当问题涉及多于两个决策变量时,图解法不再适用.但是,本节的例子中的一些观察仍然有效.线性规划问题中的每个不等式约束都描述了一个「半平面」,所有可行的解的集合就是这些「半平面」的交集,因此,总是一个「凸多边形」.规划问题的最优解总是可以在该「凸多边形」的某个「顶点」处取得.这些「顶点」的坐标可以通过联立这些「半平面」的「边界」的方程求得.将这些观察拓展到高维空间,就发展出了一个高效的求解线性规划问题的方法——单纯形法.这也是算法竞赛中最常应用的方法.
另外一个值得注意的问题是,原则上,早点师傅制作的包子和油条都不是无限可分的,应当是某个整数.虽然本题求解过程中没有明确地限制这一点,但是由于最终的最优解的确是整数,所以,即使加上整数限制,本题的答案仍然是可行的.但是对于很多规划问题,最优解可能无法取得在整点处,这些问题实际上是一类整数规划问题,而非简单的线性规划问题.本文的结尾简单地讨论了这一类问题.
基本概念
本节介绍线性规划问题的基本概念.
线性规划问题
一个线性规划问题 P P P
线性目标函数,即形如
f ( x 1 , x 2 , ⋯ , x n ) = c 1 x 1 + c 2 x 2 + ⋯ + c n x n f(x_1,x_2,\cdots,x_n)=c_1x_1+c_2x_2+\cdots+c_nx_n f ( x 1 , x 2 , ⋯ , x n ) = c 1 x 1 + c 2 x 2 + ⋯ + c n x n 的函数,其中,c i ∈ R c_i\in\mathbf R c i ∈ R
线性约束,即形如
g j ( x 1 , x 2 , ⋯ , x n ) = a j 1 x 1 + a j 2 x 2 + ⋯ + a j n x n ≤ ( = , ≥ ) b j g_j(x_1,x_2,\cdots,x_n)=a_{j1}x_1+a_{j2}x_2+\cdots+a_{jn}x_n \le (=,\ge) b_j g j ( x 1 , x 2 , ⋯ , x n ) = a j 1 x 1 + a j 2 x 2 + ⋯ + a j n x n ≤ ( = , ≥ ) b j 的不等式或等式约束,其中,a j i , b j ∈ R a_{ji},b_j\in\mathbf R a j i , b j ∈ R
线性规划问题,就是要在满足所给约束的前提下,最大化或者最小化目标函数.满足所给约束的解 ( x 1 , x 2 , ⋯ , x n ) ∈ R n (x_1,x_2,\cdots,x_n)\in\mathbf R^n ( x 1 , x 2 , ⋯ , x n ) ∈ R n 可行解 (feasible solution);在所有可行解中,使得目标函数取得最值的解称为 最优解 (optimal solution).
标准形式
为了方便描述和进一步处理,通常需要指定一个线性规划问题的标准形式.不同文献可能有不同的规定方式,本文规定线性规划的标准形式如下:
min { x i } ∑ i = 1 n c i x i subject to ∑ i = 1 n a j i x i = b i ≥ 0 , j = 1 , ⋯ , m , x i ≥ 0 , i = 1 , ⋯ , n . \begin{aligned}
\min_{\{x_i\}}\;& \sum_{i=1}^n c_ix_i \\
\text{subject to }& \sum_{i=1}^n a_{ji}x_i = b_i \ge 0,~j=1,\cdots,m,\\
& x_i \ge 0,~i = 1,\cdots,n.
\end{aligned} { x i } min subject to i = 1 ∑ n c i x i i = 1 ∑ n a j i x i = b i ≥ 0 , j = 1 , ⋯ , m , x i ≥ 0 , i = 1 , ⋯ , n . 也就是说,线性规划问题是最小化问题,所有决策变量都有非负约束,且除此之外只包含若干右侧常量非负的等式约束.利用 矩阵 可以更为简洁地表达这一问题:
max { c T x : A x = b ≥ 0 , x ≥ 0 } . \max\{c^Tx : Ax = b \ge 0,~ x\ge 0\}. max { c T x : A x = b ≥ 0 , x ≥ 0 } . 其中,x = ( x i ) ∈ R n x=(x_i)\in\mathbf R^n x = ( x i ) ∈ R n b = ( b j ) ∈ R m b=(b_j)\in\mathbf R^m b = ( b j ) ∈ R m A = ( a j i ) ∈ R m × n A=(a_{ji})\in\mathbf R^{m\times n} A = ( a j i ) ∈ R m × n
向量不等式
本文中会多次出现像 b ≥ 0 b \ge 0 b ≥ 0 x , y ∈ R n x,y\in\mathbf R^n x , y ∈ R n x ≤ y x\le y x ≤ y ∀ i ( x i ≤ y i ) \forall i(x_i\le y_i) ∀ i ( x i ≤ y i ) 偏序关系 ,也就是说,存在两个向量无法比较的情形.
标准形式的选取只是为了行文方便,而并没有任何特别之处,因为任何线性规划问题都可以等价地写成下面的六种形式:
min { c T x : A x = b , x ≥ 0 } , min { c T x : A x ≥ b } , min { c T x : A x ≥ b , x ≥ 0 } , max { c T x : A x = b , x ≥ 0 } , max { c T x : A x ≤ b } , max { c T x : A x ≤ b , x ≥ 0 } . \begin{aligned}
&\min\{c^Tx : Ax = b,~ x\ge 0\},\\
&\min\{c^Tx : Ax \ge b\},\\
&\min\{c^Tx : Ax \ge b,~ x\ge 0\},\\
&\max\{c^Tx : Ax = b,~ x\ge 0\}, \\
&\max\{c^Tx : Ax \le b\},\\
&\max\{c^Tx : Ax \le b,~ x\ge 0\}.\\
\end{aligned} min { c T x : A x = b , x ≥ 0 } , min { c T x : A x ≥ b } , min { c T x : A x ≥ b , x ≥ 0 } , max { c T x : A x = b , x ≥ 0 } , max { c T x : A x ≤ b } , max { c T x : A x ≤ b , x ≥ 0 } . 下列操作可以将所有线性规划问题都等价地转化为这六种形式之一:
通过添加负号,即将 c c c − c -c − c
通过添加负号,即将 a j T x ⪋ b j a_j^Tx \lesseqqgtr b_j a j T x ⪋ b j − a j T x ⪌ − b j -a_j^Tx \gtreqqless -b_j − a j T x ⪌ − b j
所有的等式约束 a j T x = b j a_j^Tx = b_j a j T x = b j a j T x ≥ b j a_j^Tx \ge b_j a j T x ≥ b j a j T x ≤ b j a_j^Tx \le b_j a j T x ≤ b j
所有的不等式约束 a j T x ≤ ( ≥ ) b j a_j^Tx \le(\ge) b_j a j T x ≤ ( ≥ ) b j s j s_j s j a j T x + ( − ) s j = b j a_j^Tx +(-) s_j = b_j a j T x + ( − ) s j = b j s j ≥ 0 s_j\ge 0 s j ≥ 0
如果某个决策变量 x i x_i x i x j = x j + − x j − x_j = x^+_j - x^-_j x j = x j + − x j − x j + , x j − ≥ 0 x^+_j,x^-_j \ge 0 x j + , x j − ≥ 0
通过这些操作转化得到的线性规划问题的规模不超过原问题的规模的二倍,而且这些问题的可行解和最优解都很容易相互转化.因此,对于一般形式的线性规划问题,总是可以首先将它转化为标准形式(或上述六种形式之一)再进行求解.
例子
考虑线性规划问题
max 3 x 1 − 2 x 2 + x 3 subject to 2 x 1 + 3 x 2 + 4 x 3 ≥ 1 , 3 x 1 + 4 x 2 ≤ 5 , 5 x 2 − x 3 = − 1 , x 1 , x 2 ≥ 0. \begin{aligned}
\max\;& 3x_1 - 2x_2 + x_3 \\
\text{subject to }& 2x_1 + 3x_2 + 4x_3 \ge 1,\\
& 3x_1 + 4x_2 \le 5,\\
& 5x_2 - x_3 = -1, \\
& x_1, x_2 \ge 0.
\end{aligned} max subject to 3 x 1 − 2 x 2 + x 3 2 x 1 + 3 x 2 + 4 x 3 ≥ 1 , 3 x 1 + 4 x 2 ≤ 5 , 5 x 2 − x 3 = − 1 , x 1 , x 2 ≥ 0. 通过操作 1、2 和 3 可以将它转化为形式 min { c T x : A x ≥ b } \min\{c^Tx : Ax \ge b\} min { c T x : A x ≥ b }
min − 3 x 1 + 2 x 2 − x 3 subject to 2 x 1 + 3 x 2 + 4 x 3 ≥ 1 , − 3 x 1 − 4 x 2 ≥ − 5 , 5 x 2 − x 3 ≥ − 1 , − 5 x 2 + x 3 ≥ 1 , x 1 ≥ 0 , x 2 ≥ 0. \begin{aligned}
\min\;& -3x_1 + 2x_2 - x_3 \\
\text{subject to }& 2x_1 + 3x_2 + 4x_3 \ge 1,\\
& -3x_1 - 4x_2 \ge -5,\\
& 5x_2 - x_3 \ge -1, \\
& -5x_2 + x_3 \ge 1, \\
& x_1 \ge 0,\\
& x_2 \ge 0.
\end{aligned} min subject to − 3 x 1 + 2 x 2 − x 3 2 x 1 + 3 x 2 + 4 x 3 ≥ 1 , − 3 x 1 − 4 x 2 ≥ − 5 , 5 x 2 − x 3 ≥ − 1 , − 5 x 2 + x 3 ≥ 1 , x 1 ≥ 0 , x 2 ≥ 0. 通过操作 4 和 5 可以将它转化为形式 max { c T x : A x = b , x ≥ 0 } \max\{c^Tx : Ax = b,~ x\ge 0\} max { c T x : A x = b , x ≥ 0 }
max 3 x 1 − 2 x 2 + x 3 + − x 3 − subject to 2 x 1 + 3 x 2 + 4 x 3 + − 4 x 3 − − x 4 = 1 , 3 x 1 + 4 x 2 + x 5 = 5 , 5 x 2 − x 3 + + x 3 − = − 1 , x 1 , x 2 , x 3 + , x 3 − , x 4 , x 5 ≥ 0. \begin{aligned}
\max\;& 3x_1 - 2x_2 + x^+_3 - x^-_3 \\
\text{subject to }& 2x_1 + 3x_2 + 4x^+_3 - 4x^-_3 - x_4 = 1,\\
& 3x_1 + 4x_2 + x_5 = 5,\\
& 5x_2 - x^+_3 + x^-_3 = -1, \\
& x_1, x_2, x^+_3, x^-_3, x_4, x_5 \ge 0.
\end{aligned} max subject to 3 x 1 − 2 x 2 + x 3 + − x 3 − 2 x 1 + 3 x 2 + 4 x 3 + − 4 x 3 − − x 4 = 1 , 3 x 1 + 4 x 2 + x 5 = 5 , 5 x 2 − x 3 + + x 3 − = − 1 , x 1 , x 2 , x 3 + , x 3 − , x 4 , x 5 ≥ 0.
可行域与问题的解
所有可行解的集合 D ⊆ R n \mathcal D\subseteq\mathbf R^n D ⊆ R n P P P 可行域 (feasible region).从几何角度看,每个不等式约束 a j T x ≤ b j a_j^T x \le b_j a j T x ≤ b j { x ∈ R n : a j T x ≤ b j } \{x\in\mathbf R^n:a_j^T x \le b_j\} { x ∈ R n : a j T x ≤ b j } a j T x = b j a^T_jx = b_j a j T x = b j { x ∈ R n : a j T x = b j } \{x\in\mathbf R^n:a_j^Tx=b_j\} { x ∈ R n : a j T x = b j } 1 R n \mathbf R^n R n 多面体 (polyhedron).多面体一定是闭凸集,但未必是有界的.有界的多面体也称为 多胞形 (polytope).多胞形可以看作是平面上的多边形在高维空间的推广,而多面体将它进一步推广到可能无界的情形.
多面体的例子
此处列举了一些常见的多面体:
空集 ∅ \varnothing ∅ 零胞形 (nullitope),维度规定为 − 1 -1 − 1
仿射子空间 (affine subspace),即若干超平面的交集 { x ∈ R n : A x = b } \{x\in\mathbf R^n:Ax = b\} { x ∈ R n : A x = b } A x = b Ax = b A x = b x 0 + V x_0+V x 0 + V x 0 ∈ R n x_0\in\mathbf R^n x 0 ∈ R n V ⊆ R n V\subseteq\mathbf R^n V ⊆ R n n − rank ( A ) n-\operatorname{rank}(A) n − rank ( A ) 多面体锥 (polyhedral cone),即空间中有限多个点 { x i } \{x_i\} { x i } { ∑ i α i x i : α i ≥ 0 } \{\sum_i\alpha_ix_i:\alpha_i\ge 0\} { ∑ i α i x i : α i ≥ 0 } { x ∈ R n : A x ≤ 0 } \{x\in\mathbf R^n : Ax\le 0\} { x ∈ R n : A x ≤ 0 } 多胞形,即有界的多面体.特别地,− 1 -1 − 1 0 0 0 1 1 1 2 2 2 3 3 3 { x i } \{x_i\} { x i } { ∑ i α i x i : α i ≥ 0 , ∑ i α i = 1 } \{\sum_i\alpha_ix_i:\alpha_i\ge 0,~\sum_i\alpha_i=1\} { ∑ i α i x i : α i ≥ 0 , ∑ i α i = 1 } k k k k + 1 k+1 k + 1
单纯形 (simplex),即恰由 k + 1 k+1 k + 1 k k k k k k − 1 -1 − 1 0 0 0 1 1 1 2 2 2 3 3 3 k k k { x ∈ R k : x i ≥ 0 , ∑ i x i = 1 } \{x\in\mathbf R^k:x_i\ge 0,~\sum_ix_i=1\} { x ∈ R k : x i ≥ 0 , ∑ i x i = 1 } k k k
任何多面体,都可以看作是一个多面体锥和一个多胞形的 Minkowski 和 :前者描述了多面体无界的部分,后者描述了多面体有界部分的形状.这个多面体锥是唯一的:多面体 { x ∈ R n : A x ≤ b } \{x\in\mathbf R^n:Ax\le b\} { x ∈ R n : A x ≤ b } { x ∈ R n : A x ≤ 0 } \{x\in\mathcal R^n:Ax\le 0\} { x ∈ R n : A x ≤ 0 }
线性规划的解与多面体的结构紧密相关.对于多面体 D ∈ R n \mathcal D\in\mathbf R^n D ∈ R n c ∈ R n ∖ { 0 } c\in\mathbf R^n\setminus\{0\} c ∈ R n ∖ { 0 } P P P
max { c T x : x ∈ D } . \max\{c^Tx:x\in\mathcal D\}. max { c T x : x ∈ D } . 从几何角度看,这相当于在超平面 H : c T x = z H:c^Tx = z H : c T x = z D \mathcal{D} D c c c H H H z z z
可行域 D \mathcal D D P P P P P P 不可行的 (infeasible),它的最优价值规定为 − ∞ -\infty − ∞
可行域 D \mathcal D D c c c x 0 ∈ R n x_0\in\mathbf R^n x 0 ∈ R n x 0 + t c ∈ D x_0+tc\in\mathcal D x 0 + t c ∈ D t ≥ 0 t\ge 0 t ≥ 0 c c c H H H H ∩ D H\cap\mathcal D H ∩ D c T x = c T x 0 + t c T c c^Tx = c^Tx_0 + tc^Tc c T x = c T x 0 + t c T c P P P 无界的 (unbounded),它的最优价值规定为 + ∞ +\infty + ∞
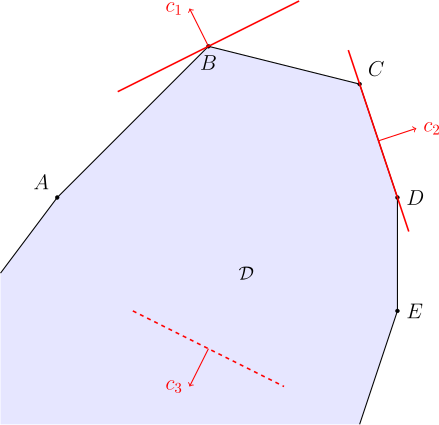
可行域 D \mathcal D D c c c P P P 有界的 (bounded).记 z ∗ ∈ R z^*\in\mathbf R z ∗ ∈ R P P P H ∗ : c T x = z ∗ H^*:c^Tx = z^* H ∗ : c T x = z ∗ D \mathcal D D D \mathcal D D { x : c T x ≤ z ∗ } \{x:c^Tx\le z^*\} { x : c T x ≤ z ∗ } D \mathcal D D 支撑超平面 (supporting hyperlane).问题 P P P H ∗ ∩ D H^*\cap\mathcal D H ∗ ∩ D H ∗ ∩ D H^*\cap\mathcal D H ∗ ∩ D D \mathcal D D D \mathcal D D 面 (face).形象地说,多面体就是由这些面围成的.除了这些由支撑超平面和多面体相交形成的面之外,一般来说,多面体还有两个面:空集和多面体本身.多面体的所有面在集合的包含关系下,形成了 格 的结构.
一个 d d d 0 0 0 d d d 0 0 0 D \mathcal D D 顶点 (vertex)或 角点 (corner point),维度为 1 1 1 D \mathcal D D 边 (edge),维度为 d − 1 d-1 d − 1 D \mathcal D D 维面 (facet).但是,并非所有多面体都有顶点.因为多面体的面的面仍然是多面体的面,而只有仿射子空间才没有严格更小的非空面,所以,多面体 D \mathcal D D D = { x ∈ R n : A x ≤ b } \mathcal D=\{x\in\mathbf R^n:Ax\le b\} D = { x ∈ R n : A x ≤ b } n − rank A n-\operatorname{rank}A n − rank A
因为多面体的面就是有界线性规划问题的解集,所以,需要搞清楚如何确定多面体的面的方程.设多面体 D \mathcal D D a j T x ⪋ b j a_j^Tx \lesseqqgtr b_j a j T x ⪋ b j F F F D \mathcal D D x ∈ F x\in F x ∈ F F F F 紧的 (tight).面 F F F D \mathcal D D F F F D \mathcal D D D \mathcal D D
特别地,标准形式的线性规划的可行域 D = { x ∈ R n : A x = b , x ≥ 0 } \mathcal D=\{x\in\mathbf R^n:Ax=b,~x\ge 0\} D = { x ∈ R n : A x = b , x ≥ 0 } ( A I ) \begin{pmatrix}A\\ I\end{pmatrix} ( A I ) n n n n n n
例子
下图中,D \mathcal D D c 1 , c 2 , c 3 c_1,c_2,c_3 c 1 , c 2 , c 3 D \mathcal D D B B B C D ‾ \overline{CD} C D D \mathcal D D c 3 c_3 c 3 c 3 c_3 c 3 c 3 c_3 c 3
这些讨论忽略了 c = 0 c=0 c = 0 0 0 0 D \mathcal D D 可行性线性规划 (feasibility linear programming).
值得指出的是,判定线性规划问题是否可行、是否有界,以及求出不等式组的可行解等问题,都和解线性规划问题本身同样困难2 3
另外,如果线性规划问题的一个约束,在可行域的所有面上都不是紧的,那么这个约束就是 冗余的 (redundant).本文开头早点师傅的例子中,工作时间的约束就是一个冗余约束.在给定的不等式组中判定某个不等式 a j T x ≤ b j a_j^Tx\le b_j a j T x ≤ b j max { a j T x : x ∈ D } \max\{a_j^Tx:x\in\mathcal D\} max { a j T x : x ∈ D } b j b_j b j
常见算法
算法竞赛中,很少有问题只能通过线性规划的算法解决.大多数可以用线性规划方法求解的题目,通常也可以通过网络流等更为专门也更为高效的算法来解决.
解决线性规划问题的常见算法如下:
尽管单纯形法的最差情形复杂度是指数级的,而内点法的复杂度是多项式的,但这两类算法在大多数实际问题中的表现都非常出色.相比之下,虽然椭球法的理论复杂度是多项式级别的,但是通常运行缓慢,并不实用.
目前尚不清楚线性规划问题是否存在强多项式复杂度的算法.
对偶问题
每个线性规划问题都对应着一个对偶问题.原问题和对偶问题的解有着紧密的联系.通过对偶问题,不仅有助于更深入地理解问题的结构,还常常可以提升原问题的求解效率.
对于线性规划问题 P P P
min x 1 , x 2 , x 3 c 1 T x 1 + c 2 T x 2 + c 3 T x 3 subject to A 11 x 1 + A 12 x 2 + A 13 x 3 ≥ b 1 , A 21 x 1 + A 22 x 2 + A 23 x 3 = b 2 , A 31 x 1 + A 32 x 2 + A 33 x 3 ≤ b 3 , x 1 ≥ 0 , x 3 ≤ 0 , \begin{aligned}
\min_{x_1,x_2,x_3}\;& c_1^Tx_1 + c_2^Tx_2 + c_3^Tx_3 \\
\text{subject to }& A_{11}x_1 + A_{12}x_2 + A_{13}x_3 \ge b_1,\\
& A_{21}x_1 + A_{22}x_2 + A_{23}x_3 = b_2,\\
& A_{31}x_1 + A_{32}x_2 + A_{33}x_3 \le b_3,\\
& x_1\ge 0,~ x_3\le 0,
\end{aligned} x 1 , x 2 , x 3 min subject to c 1 T x 1 + c 2 T x 2 + c 3 T x 3 A 11 x 1 + A 12 x 2 + A 13 x 3 ≥ b 1 , A 21 x 1 + A 22 x 2 + A 23 x 3 = b 2 , A 31 x 1 + A 32 x 2 + A 33 x 3 ≤ b 3 , x 1 ≥ 0 , x 3 ≤ 0 , 它的对偶问题 D D D
max y 1 , y 2 , y 3 b 1 T y 1 + b 2 T y 2 + b 3 T y 3 subject to A 11 T y 1 + A 21 T y 2 + A 31 T y 3 ≤ c 1 , A 12 T y 1 + A 22 T y 2 + A 32 T y 3 = c 2 , A 13 T y 1 + A 23 T y 2 + A 33 T y 3 ≥ c 3 , y 1 ≥ 0 , y 3 ≤ 0. \begin{aligned}
\max_{y_1,y_2,y_3}\;&b_1^Ty_1+b_2^Ty_2+b_3^Ty_3 \\
\text{subject to }&A_{11}^Ty_1 + A_{21}^Ty_2 + A_{31}^Ty_3\le c_1,\\
&A_{12}^Ty_1 + A_{22}^Ty_2 + A_{32}^Ty_3 = c_2,\\
&A_{13}^Ty_1 + A_{23}^Ty_2 + A_{33}^Ty_3 \ge c_3,\\
&y_1\ge 0,~ y_3\le 0.
\end{aligned} y 1 , y 2 , y 3 max subject to b 1 T y 1 + b 2 T y 2 + b 3 T y 3 A 11 T y 1 + A 21 T y 2 + A 31 T y 3 ≤ c 1 , A 12 T y 1 + A 22 T y 2 + A 32 T y 3 = c 2 , A 13 T y 1 + A 23 T y 2 + A 33 T y 3 ≥ c 3 , y 1 ≥ 0 , y 3 ≤ 0. 其中,对偶问题的决策变量 y 1 , y 2 , y 3 y_1,y_2,y_3 y 1 , y 2 , y 3 x 1 , x 2 , x 3 x_1,x_2,x_3 x 1 , x 2 , x 3
原问题 P P P D D D
最小化问题 最大化问题 大于等于约束 非负变量 小于等于约束 非正变量 等式约束 无约束变量 非负变量 小于等于约束 非正变量 大于等于约束 无约束变量 等式约束 目标函数系数 约束右侧常量 约束右侧常量 目标函数系数
特别地,标准形式的线性规划问题
min { c T x : A x = b , x ≥ 0 } \min\{c^Tx:Ax=b,~x\ge 0\} min { c T x : A x = b , x ≥ 0 } 的对偶问题是
max { b T y : A T y ≤ c } . \max\{b^Ty:A^Ty\le c\}. max { b T y : A T y ≤ c } . 对偶原理
原问题和对偶问题不仅在形式上互为镜像,而且两者的解也紧密相关.这称为 对偶原理 (duality principal).为表述方便,本节在叙述和证明定理时,将采用标准形式的原问题.
首先,弱对偶定理 (weak duality theorem)说明,对偶问题的最大值不超过原问题的最小值.
弱对偶定理
对于所有 A ∈ R m × n A\in\mathbf R^{m\times n} A ∈ R m × n b ∈ R m b\in\mathbf R^m b ∈ R m c ∈ R n c\in\mathbf R^n c ∈ R n
max { b T y : A T y ≤ c } ≤ min { c T x : A x = b , x ≥ 0 } . \max\{b^Ty:A^Ty\le c\} \le \min\{c^Tx:Ax=b,~x\ge 0\}. max { b T y : A T y ≤ c } ≤ min { c T x : A x = b , x ≥ 0 } .
证明
如果原问题和对偶问题中的任何一个不可行,那么该不等式就是平凡的.假设两个问题都是可行的.那么,对于所有可行的 x x x y y y
b T y = x T A T y ≤ x T c . b^Ty = x^TA^Ty \le x^Tc. b T y = x T A T y ≤ x T c . 因此,将两侧取最值,就得到弱对偶定理成立.
基于弱对偶定理,原问题和对偶问题的解的情况只能有下面四种情形:
原问题和对偶问题均不可行,即 − ∞ ≤ + ∞ -\infty\le+\infty − ∞ ≤ + ∞
原问题不可行,对偶问题无界,即 + ∞ ≤ + ∞ +\infty\le+\infty + ∞ ≤ + ∞
原问题无界,对偶问题不可行,即 − ∞ ≤ − ∞ -\infty\le-\infty − ∞ ≤ − ∞
原问题和对偶问题均有界.
弱对偶定理有很多推论.例如,它实际上给出了利用原问题和对偶问题的可行性判定原问题无界的方法.
推论
线性规划问题无界,当且仅当它可行,且它的对偶问题不可行.
将弱对偶定理应用于可行性线性规划问题,就得到 Farkas 引理(和它的各种变体).
Farkas 引理
对于 A ∈ R m × n A\in\mathbf R^{m\times n} A ∈ R m × n b ∈ R n b\in\mathbf R^n b ∈ R n
存在 x ∈ R n x\in\mathbf R^n x ∈ R n A x = b Ax=b A x = b x ≥ 0 x\ge 0 x ≥ 0
存在 y ∈ R m y\in\mathbf R^m y ∈ R m A T y ≥ 0 A^T y\ge 0 A T y ≥ 0 b T y < 0 b^Ty<0 b T y < 0
证明
考虑线性规划问题 max { 0 : A x = b , x ≥ 0 } \max\{0:Ax=b,~x\ge 0\} max { 0 : A x = b , x ≥ 0 } min { b T y : A T y ≥ 0 } \min\{b^Ty:A^Ty\ge 0\} min { b T y : A T y ≥ 0 } 0 ∈ R m 0\in\mathbf R^m 0 ∈ R m
Farkas 实际上是一种 超平面分离定理 .情形 1 是在说,点 b b b A A A C C C b b b C C C y y y H : y T x = 0 H:y^Tx = 0 H : y T x = 0 b b b C C C
事实上,对于弱对偶定理允许的第四种情形,有更强的结论成立:原问题和对偶问题的最优值是相等的.将后三种情形合在一起,就得到 强对偶定理 (strong duality theorem):只要原问题或对偶问题之一是可行的,它们的最优值就必然相等.
强对偶定理
对于所有 A ∈ R m × n A\in\mathbf R^{m\times n} A ∈ R m × n b ∈ R m b\in\mathbf R^m b ∈ R m c ∈ R n c\in\mathbf R^n c ∈ R n
max { b T y : A T y ≤ c } = min { c T x : A x = b , x ≥ 0 } . \max\{b^Ty:A^Ty\le c\} = \min\{c^Tx:Ax=b,~x\ge 0\}. max { b T y : A T y ≤ c } = min { c T x : A x = b , x ≥ 0 } . 只要两个集合之一非空.
证明
弱对偶定理唯一没有包含的情形,就是原问题和对偶问题都可行的情形.此时,考虑如下可行性线性规划问题 Q Q Q
max { 0 : c T x ≤ b T y , A x = b , x ≥ 0 , A T y ≤ c } . \max\{0:c^Tx \le b^Ty,~Ax=b,~x\ge 0,~A^Ty\le c\}. max { 0 : c T x ≤ b T y , A x = b , x ≥ 0 , A T y ≤ c } . 如果问题 Q Q Q ( x ∗ , y ∗ ) ∈ R n × R m (x^*,y^*)\in\mathbf R^n\times\mathbf R^m ( x ∗ , y ∗ ) ∈ R n × R m
b T y ∗ ≤ max { b T y : A T y ≤ c } ≤ min { c T x : A x = b , x ≥ 0 } ≤ c T x ∗ , b^Ty^* \le \max\{b^Ty:A^Ty\le c\} \le \min\{c^Tx:Ax=b,~x\ge 0\} \le c^Tx^*, b T y ∗ ≤ max { b T y : A T y ≤ c } ≤ min { c T x : A x = b , x ≥ 0 } ≤ c T x ∗ , 但是 c T x ∗ ≤ b T y ∗ c^Tx^*\le b^Ty^* c T x ∗ ≤ b T y ∗ x ∗ x^* x ∗ y ∗ y^* y ∗
因此,只需要证明问题 Q Q Q Q Q Q D Q DQ D Q
min { c T μ − b T λ : c t − A T λ ≥ 0 , − b t + A μ = 0 , t ≥ 0 , μ ≥ 0 } . \min\{c^T\mu - b^T\lambda : ct - A^T\lambda \ge 0,~ -bt + A\mu = 0,~t\ge 0,~\mu\ge 0\}. min { c T μ − b T λ : c t − A T λ ≥ 0 , − b t + A μ = 0 , t ≥ 0 , μ ≥ 0 } . 因为 ( t , λ , μ ) = ( 0 , 0 , 0 ) (t,\lambda,\mu)=(0,0,0) ( t , λ , μ ) = ( 0 , 0 , 0 ) D Q DQ D Q Q Q Q D Q DQ D Q ( t ∗ , λ ∗ , μ ∗ ) (t^*,\lambda^*,\mu^*) ( t ∗ , λ ∗ , μ ∗ )
c T μ ∗ − b T λ ∗ < 0 , c t ∗ − A T λ ∗ ≥ 0 , − b t ∗ + A μ ∗ = 0 , t ∗ ≥ 0 , μ ∗ ≥ 0. c^T\mu^* - b^T\lambda^* <0,~ ct^* - A^T\lambda^* \ge 0,~ -bt^* + A\mu^* = 0,~t^*\ge 0,~\mu^*\ge 0. c T μ ∗ − b T λ ∗ < 0 , c t ∗ − A T λ ∗ ≥ 0 , − b t ∗ + A μ ∗ = 0 , t ∗ ≥ 0 , μ ∗ ≥ 0. 此时,如果 t ∗ > 0 t^*>0 t ∗ > 0 ( x , y ) = ( μ ∗ / t ∗ , λ ∗ / t ∗ ) (x,y)=(\mu^*/t^*,\lambda^*/t^*) ( x , y ) = ( μ ∗ / t ∗ , λ ∗ / t ∗ ) t ∗ = 0 t^*=0 t ∗ = 0
c T μ ∗ < b T λ ∗ , A T λ ∗ ≤ 0 , A μ ∗ = 0 , μ ∗ ≥ 0. c^T\mu^* < b^T\lambda^*,~ A^T\lambda^*\le 0,~ A\mu^*=0,~\mu^*\ge 0. c T μ ∗ < b T λ ∗ , A T λ ∗ ≤ 0 , A μ ∗ = 0 , μ ∗ ≥ 0. 但是,因为已经假设定理中的原问题和对偶问题都可行,也就是说,存在 ( x 0 , y 0 ) (x_0,y_0) ( x 0 , y 0 )
A x 0 = b , x 0 ≥ 0 , A T y 0 ≤ c Ax_0 = b,~ x_0\ge 0,~ A^Ty_0\le c A x 0 = b , x 0 ≥ 0 , A T y 0 ≤ c 成立,所以,有
0 = ( A μ ∗ ) T y 0 = ( A T y 0 ) T μ ∗ ≤ c T μ ∗ < b T λ ∗ = x 0 T A T λ ∗ ≤ 0. 0 = (A\mu^*)^Ty_0 = (A^Ty_0)^T\mu^* \le c^T\mu^* < b^T\lambda^* = x_0^TA^T\lambda^* \le 0. 0 = ( A μ ∗ ) T y 0 = ( A T y 0 ) T μ ∗ ≤ c T μ ∗ < b T λ ∗ = x 0 T A T λ ∗ ≤ 0. 这显然矛盾.这一矛盾说明问题 Q Q Q
从强对偶定理的证明过程还能得到如下推论:
推论
设原问题和对偶问题的一组可行解 x ∗ x^* x ∗ y ∗ y^* y ∗ c T x ∗ = b T y ∗ c^Tx^* = b^Ty^* c T x ∗ = b T y ∗
强对偶定理说明,对于可行的线性规划问题,只需要求解它的对偶问题,就能够得到原问题的最优价值.
互补松弛条件
和其它的优化问题一样,互补松弛条件是线性规划问题的最优性条件的一部分.而且,因为目标函数是线性的,所以对于线性规划问题来说,互补松弛条件是可行解成为最优解的充分必要条件.
所谓 互补松弛 (complementary slackness)条件,就是指只有在原问题(对偶问题)中的约束取得等号(即约束是紧的)的时候,对偶问题(原问题)中与之对应的变量才能取非零值.如果将变量取非零值也当成一条松弛的约束,那么这就相当于说,原问题和对偶问题中相对应的变量和约束不能同时是松弛的.因此,这一条件称为互补松弛条件.
以标准形式的线性规划问题为例,如下结论成立:
定理
假设 x ∗ x^* x ∗ y ∗ y^* y ∗ min { c T x : A x = b , x ≥ 0 } \min\{c^Tx:Ax=b,~x\ge 0\} min { c T x : A x = b , x ≥ 0 } max { b T y : A T y ≤ c } \max\{b^Ty:A^Ty\le c\} max { b T y : A T y ≤ c }
x T ( A T y − c ) = 0 x^T(A^Ty-c) = 0 x T ( A T y − c ) = 0 时,x ∗ x^* x ∗ y ∗ y^* y ∗
证明
因为 x ∗ x^* x ∗ y ∗ y^* y ∗
b T y ∗ − c T x ∗ = ( x ∗ ) T ( A T y ∗ − c ) . b^Ty^* - c^Tx^* = (x^*)^T(A^T y^* - c). b T y ∗ − c T x ∗ = ( x ∗ ) T ( A T y ∗ − c ) . 因此,互补松弛条件成立,当且仅当 b T y ∗ = c T x ∗ b^Ty^* = c^Tx^* b T y ∗ = c T x ∗ x ∗ x^* x ∗ y ∗ y^* y ∗
标准形式可能太过特殊.该定理的稍微一般的形式如下:
定理
假设 x ∗ x^* x ∗ y ∗ y^* y ∗ min { c T x : A x ≥ b , x ≥ 0 } \min\{c^Tx:Ax\ge b,~x\ge 0\} min { c T x : A x ≥ b , x ≥ 0 } max { b T y : A T y ≤ c , y ≥ 0 } \max\{b^Ty:A^Ty\le c,~y\ge 0\} max { b T y : A T y ≤ c , y ≥ 0 }
x T ( A T y − c ) = y T ( A x − b ) = 0 x^T(A^Ty-c) = y^T(Ax-b) = 0 x T ( A T y − c ) = y T ( A x − b ) = 0 时,x ∗ x^* x ∗ y ∗ y^* y ∗
证明
证明基本同上,只是这次要将差值写成
b T y ∗ − c T x ∗ = ( x ∗ ) T ( A T y ∗ − c ) − ( y ∗ ) T ( A x ∗ − b ) . b^Ty^* - c^Tx^* = (x^*)^T(A^T y^* - c) - (y^*)^T(Ax^*-b). b T y ∗ − c T x ∗ = ( x ∗ ) T ( A T y ∗ − c ) − ( y ∗ ) T ( A x ∗ − b ) .
互补松弛条件提供了判断线性规划问题的可行解的最优性的简单条件.
原始‑对偶方法
对偶问题可以辅助原问题的求解.在解决线性规划问题时,常常会用到的一种方法是 原始‑对偶方法 (primal-dual method).它通过求解一系列相对简单的辅助问题,逐步改进对偶问题的解,进而获得原始问题的最优解.
对于标准形式的原问题
( P ) min { c T x : A x = b ≥ 0 , x ≥ 0 } (P)\qquad\min\{c^Tx : Ax=b\ge 0,~ x\ge 0\} ( P ) min { c T x : A x = b ≥ 0 , x ≥ 0 } 和它的对偶问题
( D ) max { b T y : A T y ≤ c } , (D)\qquad\max\{b^Ty : A^Ty\le c\}, ( D ) max { b T y : A T y ≤ c } , 上一节已经说明,要找到它们的最优解,只需要找到问题 ( P ) (P) ( P ) ( D ) (D) ( D ) x T ( A T y − c ) = 0 x^T(A^Ty-c)=0 x T ( A T y − c ) = 0
从对偶问题 ( D ) (D) ( D ) y y y
I = { i : ( A T y − c ) i = 0 } . I = \{i : (A^Ty - c)_i = 0\}. I = { i : ( A T y − c ) i = 0 } .
根据互补松弛条件,如果存在问题 ( P ) (P) ( P ) x x x x i > 0 x_i>0 x i > 0 i ∈ I i\in I i ∈ I
( R P ) min x , s 1 T s subject to A x + s = b , x i ≥ 0 , ∀ i ∈ I , x i = 0 , ∀ i ∉ I , s ≥ 0. (RP)\qquad
\begin{aligned}
\min_{x,s}\;& \mathbf 1^Ts \\
\text{subject to } & Ax + s = b, \\
& x_i \ge 0,~\forall i \in I,\\
& x_i = 0,~\forall i \notin I,\\
& s \ge 0.
\end{aligned} ( R P ) x , s min subject to 1 T s A x + s = b , x i ≥ 0 , ∀ i ∈ I , x i = 0 , ∀ i ∈ / I , s ≥ 0.
如果问题 ( R P ) (RP) ( R P ) 0 0 0 ( x ∗ , 0 ) (x^*,0) ( x ∗ , 0 ) x ∗ x^* x ∗ ( P ) (P) ( P ) ( D R P ) (DRP) ( D R P ) y ˉ \bar y y ˉ
( D R P ) max y b T y subject to ∑ j a j i y j ≤ 0 , ∀ i ∈ I , y ≤ 1. (DRP)\qquad
\begin{aligned}
\max_{y}\;& b^Ty \\
\text{subject to }& \sum_{j}a_{ji}y_j \le 0,~\forall i\in I,\\
& y \le 1.
\end{aligned} ( D R P ) y max subject to b T y j ∑ a j i y j ≤ 0 , ∀ i ∈ I , y ≤ 1. 根据强对偶定理可知,b T y ˉ = 1 T s ∗ > 0 b^T\bar y = 1^Ts^*>0 b T y ˉ = 1 T s ∗ > 0
根据问题 ( D R P ) (DRP) ( D R P ) ( D ) (D) ( D ) y ′ = y + ε y ˉ y' = y + \varepsilon \bar y y ′ = y + ε y ˉ ε > 0 \varepsilon>0 ε > 0 b T y ′ = b T y + ε b T y ˉ > b T y b^Ty' = b^Ty + \varepsilon b^T\bar y > b^Ty b T y ′ = b T y + ε b T y ˉ > b T y y ′ y' y ′ ( D ) (D) ( D ) ε \varepsilon ε
对于 i ∈ I i\in I i ∈ I
∑ j a j i y j ′ = ∑ j a j i y j + ε ∑ j a j i y ˉ j ≤ c i , \sum_ja_{ji}y'_j = \sum_ja_{ji}y_j + \varepsilon \sum_ja_{ji}\bar y_j \le c_i, j ∑ a j i y j ′ = j ∑ a j i y j + ε j ∑ a j i y ˉ j ≤ c i , 所以,问题 ( D ) (D) ( D )
对于剩下的约束,即 i ∉ I i\notin I i ∈ / I
ε = min { c i − ∑ j a j i y j ∑ j a j i y ˉ j : i ∉ I , ∑ j a j i y ˉ j > 0 } \varepsilon = \min\left\{\dfrac{c_i - \sum_{j}a_{ji}y_j}{\sum_{j}a_{ji}\bar y_j}:i\notin I,~\textstyle\sum_{j}a_{ji}\bar y_j>0\right\} ε = min { ∑ j a j i y ˉ j c i − ∑ j a j i y j : i ∈ / I , ∑ j a j i y ˉ j > 0 } 就可以在保证可行性的前提下,尽可能大地改进对偶问题的解,然后回到步骤 1 继续迭代.特别地,如果上式中的集合为空集,即 ε = + ∞ \varepsilon=+\infty ε = + ∞ ( D ) (D) ( D ) ( P ) (P) ( P )
这个过程中其实只有问题 ( D R P ) (DRP) ( D R P ) ( R P ) (RP) ( R P ) ( D R P ) (DRP) ( D R P ) ( D ) (D) ( D ) ( D R P ) (DRP) ( D R P ) ( D R P ) (DRP) ( D R P ) y ≤ 1 y\le 1 y ≤ 1 ( D R P ) (DRP) ( D R P )
算法竞赛中,原始‑对偶方法广泛地应用于各类组合优化问题.例如二分图最大权匹配的 匈牙利算法 、最小费用流的 消圈算法 和 SSP 算法(原始‑对偶算法) 、最短路的 Dijkstra 算法 、最大流的 Ford–Fulkerson 增广算法 等,都可以看作是原始‑对偶方法的直接应用.
整数规划
整数规划 (integer programming)通常指 整数线性规划 (integer linear programming, ILP).标准形式的整数线性规划如下:
min x c T x subject to A x = b ≥ 0 , x ≥ 0 , x ∈ Z n , \begin{aligned}
\min_{x}\; & c^Tx \\
\text{subject to } & Ax = b \ge 0,\\
& x \ge 0,\\
& x \in \mathbf Z^n,
\end{aligned} x min subject to c T x A x = b ≥ 0 , x ≥ 0 , x ∈ Z n , 其中,A ∈ R m × n A\in\mathbf R^{m\times n} A ∈ R m × n b ∈ R m b\in\mathbf R^m b ∈ R m c ∈ R n c\in\mathbf R^n c ∈ R n
整数约束显著增加了整数规划问题的复杂性.许多组合优化问题,例如背包问题、适定性问题以及众多图论中的优化问题,都可以表示为整数规划模型,而这些问题中的多数被证明是 NP 困难的.
全幺模矩阵
正因如此,对于很多大规模的整数优化问题,有时候会考虑将它的整数约束松弛掉,转而求解一个线性规划问题.通常来说,松弛后的线性规划问题的最优价值只是原来的整数规划问题的一个下界估计(假设问题是最小化问题).但是,如果松弛后的线性规划问题的最优解恰好是整数解,那么,它也一定是原来的整数规划问题的最优解.
一个自然的问题是,是否存在条件,能够保证线性规划问题的最优解都是整数解?全幺模矩阵的概念就提供了这样的一个条件.
全幺模矩阵
如果矩阵 A ∈ R m × n A\in\mathbf R^{m\times n} A ∈ R m × n 0 0 0 ± 1 \pm 1 ± 1 A A A 全幺模矩阵 (totally unimodular matrix).
特别地,全幺模矩阵的所有元素都是 0 0 0 ± 1 \pm 1 ± 1
定理
对于全幺模矩阵 A ∈ Z m × n A\in\mathbf Z^{m\times n} A ∈ Z m × n b ∈ Z m b\in\mathbf Z^{m} b ∈ Z m c ∈ Z n c\in\mathbf Z^n c ∈ Z n
min { c T x : A x = b , x ≥ 0 } = max { b T y : A T y ≤ c } \min\{c^Tx : Ax=b,x\ge 0\} = \max\{b^Ty: A^Ty\le c\} min { c T x : A x = b , x ≥ 0 } = max { b T y : A T y ≤ c } 都有整数最优解,只要它们都有界.
证明
前文已经说明,线性规划问题的最优解集可以取作它的一个极小面,而后者是由若干线性独立的紧约束作为等式联立得到的方程组的解:
{ x ∈ R n : a j T x = b j , ∀ j ∈ J } . \{x\in\mathbf R^n : a_j^Tx = b_j,~\forall j\in J\}. { x ∈ R n : a j T x = b j , ∀ j ∈ J } . 记这个方程组为 A J x = b J A_Jx=b_J A J x = b J A J = ( A 1 , A 2 ) A_J=(A_1,A_2) A J = ( A 1 , A 2 ) A 1 A_1 A 1 ± 1 \pm 1 ± 1
x = ( A 1 − 1 b J 0 ) x = \begin{pmatrix}A_1^{-1}b_J \\ 0\end{pmatrix} x = ( A 1 − 1 b J 0 ) 就是极小面上的一个整数解.
常见的图论模型中,网络流、最短路、二分图等对应的线性规划问题的系数矩阵都是全幺模矩阵.因此,只需要这些问题仅涉及整数参数,它们的最优解就可以取作整数,而不用担心线性规划问题的解对应着分数流、分数匹配等情形.所以,最大流 、最小割 、最小费用流 、最短路 、差分约束 、二分图最大(权)匹配和最小点覆盖 等问题,都可以转化为线性规划问题求解.而且,最大流与最小割、最短路与差分约束、二分图最大匹配和最小点覆盖,两两互为对偶问题.
除此之外,还有一些常见的图论模型,它所有的可行解恰巧是某个顶点均为整点的多胞形的全体顶点.因此,可以通过巧妙地选取约束,使得相应的组合优化问题的解,恰为某个线性规划问题的最优解.例如,一般图匹配和生成树等图论模型都属于这种情况,因此 一般图最大(权)匹配 和 最小生成树 等问题同样可以转化为线性规划问题.
参考文献与注释
Schrijver, Alexander. Theory of linear and integer programming. John Wiley & Sons, 1998.
Papadimitriou, Christos H., and Kenneth Steiglitz. Combinatorial optimization: algorithms and complexity. Courier Corporation, 1998.
Duality in linear programming. Part 1—definition and construction. by adamant - Codeforces blog Duality in linear programming. Part 2—in competitive programming. by adamant - Codeforces blog