前言
1959 年,「支配」这一概念由 Reese T. Prosser 在 一篇关于网络流的论文 中提出,但并未提出具体的求解算法;直到 1969 年,Edward S. Lowry 和 C. W. Medlock 才首次提出了 有效的求解算法.而目前使用最为广泛的 Lengauer–Tarjan 算法则由 Lengauer 和 Tarjan 于 1979 年在 一篇论文 中提出.
在 OI 界中,支配树的概念最早在 ZJOI2012 灾难 中被引入,当时也被称为「灭绝树」;陈孙立也在 2020 年的国家集训队论文中介绍了这一算法.
目前支配树在竞赛界并不流行,其相关习题并不多见;但支配树在工业上,尤其是编译器相关领域,已有广泛运用.
本文将介绍支配树的概念及几种求解方法.
支配关系
我们在任意的一个有向图上钦定一个入口结点 ,对于一个结点 ,若从 到 的每一条路径都经过某一个结点 ,那么我们称 支配 ,也称 是 的一个 支配点,记作 .
对于从 出发无法到达的结点,讨论其支配关系是没有意义的,因此在没有特殊说明的情况下,本文默认 能到达图上任何一个结点.
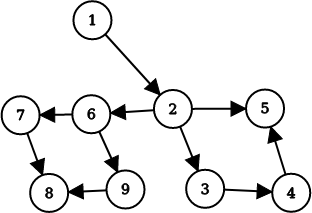
例如这张有向图中, 被 支配, 被 支配,4 被 支配,5 被 支配,etc.
引理
在下文的引理中,默认
引理 1: 是其所有结点的支配点;任意一个结点都是其自身的支配点.
证明: 显然任何一条从 到 的路径都必须经过 和 这两个结点.
引理 2: 仅考虑简单路径得出的支配关系与考虑所有路径得出的关系相同.
证明: 对于非简单路径,我们设两次经过某个结点之间经过的所有结点的点集为 ,若将 中的结点删去,便能将每个非简单路径与一个简单路径对应.
在 中,在非简单路径而不在简单路径上的点一定不可能成为支配点,因为至少有一条 到 的简单路径不包括这个点;同时在简单路径和非简单路径上的点只需在简单路径上讨论即可.
综上,删去非简单路径对支配关系没有影响.
引理 3: 如果 , ,则 .
证明: 经过 的路径必定经过 ,经过 的路径必定经过 ,因此经过 的路径必定经过 ,即 .
引理 4: 如果 ,,则 .
证明: 假设 ,则任意一个到达 的路径都已经到达过 ,同时任意一个到达 的路径都已经到达过 ,矛盾.
引理 5: 若 , 且 ,则有 或 .
证明: 考虑一条 的路径,若 , 不存在支配关系,则一定存在一条不经过 的从 到 的路径,即存在一条 的路径,与 矛盾.
求解支配关系
结点删除法
一个和定义等价的结论:如果我们删去图中的某一个结点后,有一些结点变得不可到达,那么这个被删去的结点支配这些变得不可到达的结点.
因此我们只要尝试将每一个结点删去后 dfs 即可,代码复杂度为 .下面给出核心代码.
// 假设图中有 n 个结点, 起始点 s = 1
std::bitset<N> vis;
std::vector<int> edge[N];
std::vector<int> dom[N];

void dfs(int u, int del) {
  vis[u] = true;
  for (int v : edge[u]) {
    if (v == del or vis[v]) {
      continue;
    }
    dfs(v, del);
  }
}

void getdom() {
  for (int i = 2; i <= n; ++i) {
    vis.reset();
    dfs(1, i);
    for (int j = 1; j <= n; ++j) {
      if (!vis[j]) {
        dom[j].push_back(i);
      }
    }
  }
}
数据流迭代法
数据流迭代法也是 OI 中不常见的一个知识点,这里先做简要介绍.
数据流分析是编译原理中的概念,用于分析数据如何在程序执行路径上的流动;而数据流迭代法是在程序的流程图的结点上列出方程并不断迭代求解,从而求得程序的某些点的数据流值的一种方法.这里我们就是把有向图看成了一个程序流程图.
这个问题中,方程为:
其中 定义为 的前驱结点组成的点集.这个方程可以通过引理 3 得到.
翻译成人话就是,一个点的支配点的点集为它所有前驱结点的支配点集的交集,再并上它本身.根据这个方程将每个结点上的支配点集不断迭代直至答案不变即可.
为了提高效率,我们希望每轮迭代时,当前迭代的结点的所有前驱结点尽可能都已经执行完了这次迭代,因此我们要利用深度优先排序得出这个图的逆后序,根据这个顺序进行迭代.
下面给出核心代码的参考实现.这里需要预先处理每个点的前驱结点集和图的逆后序,但这不是本文讨论的主要内容,故这里不提供参考实现.
std::vector<int> pre[N];  // 每个结点的前驱结点
std::vector<int> ord;     // 图的逆后序
std::bitset<N> dom[N];
std::vector<int> Dom[N];

void getdom() {
  dom[1][1] = true;
  flag = true;
  while (flag) {
    flag = false;
    for (int u : ord) {
      std::bitset<N> tmp;
      tmp[u] = true;
      for (int v : pre[u]) {
        tmp &= dom[v];
      }
      if (tmp != dom[u]) {
        dom[u] = tmp;
        flag = true;
      }
    }
  }
  for (int i = 2; i <= n; ++i) {
    for (int j = 1; j <= n; ++j) {
      if (dom[i][j]) {
        Dom[i].push_back(j);
      }
    }
  }
}
不难看出上述算法的复杂度为 .
支配树
上一节我们发现,除 外,一个点的支配点至少有两个, 和其自身.
我们将任意一个结点 的支配点中,除自身外与自己距离最近的结点 称作 的直接支配点,记作 .显然除了 没有直接支配点外,每个结点都有唯一一个直接支配点.
我们考虑对于除 外每一个结点 从 向 连边,便构成了一个有 个结点, 条边的有向图.根据引理 3 和引理 4,我们知道支配关系一定不会构成循环,也就是这些边一定不构成环,因此我们得到的图事实上是一棵树.我们称这颗树为原图的 支配树.
求解支配树
根据 dom 求解
不妨考虑某个结点的支配点集 ,则一定存在一条路径 .显然 的直接支配点为 .因此直接支配点的定义等价于:
对于一个结点 的支配点集 ,若 满足 ,则 .
因此,利用前文所述的算法得到每个结点的支配点集之后,我们根据上述定义便能很轻松地得到每个点的直接支配点,从而构造出支配树.下面给出参考代码.
std::bitset<N> dom[N];
std::vector<int> Dom[N];
int idom[N];

void getidom() {
  for (int u = 2; u <= n; ++u) {
    for (int v : Dom[u]) {
      std::bitset<N> tmp = (dom[v] & dom[u]) ^ dom[u];
      if (tmp.count() == 1 and tmp[u]) {
        idom[u] = v;
        break;
      }
    }
  }
  for (int u = 2; u <= n; ++u) {
    e[idom[u]].push_back(u);
  }
}
树上的特例
显然树型图的支配树就是它本身.
DAG 上的特例
我们发现 DAG 有一个很好的性质:根据拓扑序求解,先求得的解不会对后续的解产生影响.我们可以利用这个特点快速求得 DAG 的支配树.
提醒
值得注意的是此处的 DAG 只能有一个起点,如果有多个起点,受起点支配的点在支配树上出现有多个父亲的情况,从而使支配关系不能简单的用支配树来表达.
引理 6: 在有向图上, 当且仅当 .
证明: 首先来证明充分性.考虑任意一条从 到 的路径都一定经过一个结点 ,而 支配这个结点,因此任意一条从 到 的路径都一定经过 ,因此我们得到 .
然后是必要性.如果 , 不支配 ,则一定有一条不经过 的路径 ,因此 不支配 .
我们发现, 的支配点一定是其所有前驱结点在支配树上的公共祖先,那么显然 的直接支配点是所有前驱结点在支配树上的 LCA.考虑倍增求解 LCA 可以支持每次添加一个结点,上述算法显然是可行的.
下面给出参考实现:
std::stack<int> sta;
std::vector<int> e[N], g[N], tree[N];  // g 是原图的反图,tree 是支配树
int n, s, in[N], tpn[N], dep[N], idom[N];  // n 为总点数,s 为起始点,in 为入度
int fth[N][17];

void topo(int s) {
  sta.push(s);
  while (!sta.empty()) {
    int u = sta.top();
    sta.pop();
    tpn[++tot] = u;
    for (int v : e[u]) {
      --in[v];
      if (!in[v]) {
        sta.push(v);
      }
    }
  }
}

int lca(int u, int v) {
  if (dep[u] < dep[v]) {
    std::swap(u, v);
  }
  for (int i = 15; i >= 0; --i) {
    if (dep[fth[u][i]] >= dep[v]) {
      u = fth[u][i];
    }
  }
  if (u == v) {
    return u;
  }
  for (int i = 15; i >= 0; --i) {
    if (fth[u][i] != fth[v][i]) {
      u = fth[u][i];
      v = fth[v][i];
    }
  }
  return fth[u][0];
}

void build() {
  topo(s);
  for (int i = 1; i <= n; ++i)
    for (int j = 0; j <= 15; ++j) fth[i][j] = s;
  for (int i = 1; i <= n; ++i) {
    int u = tpn[i];
    if (g[u].size()) {
      int v = g[u][0];
      for (int j = 1, q = g[u].size(); j < q; ++j) {
        v = lca(v, g[u][j]);
      }
      tree[v].push_back(u);
      fth[u][0] = v;
      dep[u] = dep[v] + 1;
      for (int i = 1; i <= 15; ++i) {
        fth[u][i] = fth[fth[u][i - 1]][i - 1];
      }
    }
  }
}
Lengauer–Tarjan 算法
Lengauer–Tarjan 算法是求解支配树最有名的算法之一,可以在 的时间复杂度内求出一个有向图的支配树.这一算法引入了 半支配点 的概念,并通过半支配点辅助求得直接支配点.
约定
首先,我们从 出发对这个有向图进行 dfs,所经过的点和边形成了一颗树 .我们称走过的边为树边,其余的为非树边;令 表示结点 被第几个遍历到;定义 当且仅当 .
半支配点
一个结点 的半支配点,是满足从这个结点 出发有一条路径,路径上除了 之外每个结点都大于 的结点中最小的那一个.形式化的说, 的半支配点 定义为:
我们发现半支配点有一些有用的性质:
引理 7: 对于任意结点 ,.
证明: 根据定义不难发现, 在 上的父亲 也满足成为半支配点的条件,且 ,因此任何大于 的结点都不可能成为其半支配点.
引理 8: 对于任意结点 , 是其在 上的祖先.
证明: 上从 到 的路径对应了原图上的一条路径,则 必定在这个路径上.
引理 9: 对于任意结点 , 是其在 上的祖先.
证明: 假设 不是 的祖先,那么 不可能连向任何 序大于等于 的结点(否则这个点应在 的子树内而非其他子树内),矛盾.
引理 10: 对于任意结点 , 是 的祖先.
证明: 考虑可以从 到 再从定义中的路径走到 .根据定义, 到 的路径上的点均不支配 ,故 一定是 的祖先.
引理 11: 对于任意结点 满足 是 的祖先,则要么有 是 的祖先,要么 是 的祖先.
证明: 对于任意在 和 之间的结点 ,根据直接支配点的定义,一定存在一条不经过 的,从 到 再到 的路径.因此这些结点 一定不是 ,因此 要么是 的后代,要么是 的祖先.
根据以上引理,我们可以得到以下定理:
定理 1: 一个点 的半支配点是其前驱与其支配点在 上的,大于 的所有祖先的半支配点中最小的节点.形式化地说,.
证明: 令 等于上式右侧.
我们首先证明 .根据引理 7 我们知道这个命题等价于证明上述的两种都满足成为半支配点的条件. 是 的前驱时的情况是显然的,对于后半部分,我们考虑将半支配点定义中所述路径 和 上的一条满足 的路径 以及路径 拼接,从而我们构造出一条满足半支配点定义的路径.
然后我们证明 .考虑 到其半支配点的定义中所述路径 .不难看出 和 分别对应了定义中的两个选取方法.若 ,则存在有向边 ,根据引理 7 即可得证;若 ,令 是满足 且 是 在 上祖先的最小数.考虑到 满足上述条件,这样的 一定存在.
考虑证明 是满足成为 半支配点条件的一条路径,即证明 .若不是,则令 为满足 中使 最小的数,根据引理 11 我们知道 是 的祖先,这和 的定义矛盾.于是 .综上 ,故 .
根据定理 1 我们便可以求出每个点的半支配点了.不难发现计算半支配点的复杂度瓶颈在第二种情况上,我们考虑利用带权并查集优化,每次路径压缩时更新最小值即可.
void dfs(int u) {
  dfn[u] = ++dfc;
  pos[dfc] = u;
  for (int i = h[0][u]; i; i = e[i].x) {
    int v = e[i].v;
    if (!dfn[v]) {
      dfs(v);
      fth[v] = u;
    }
  }
}

int find(int x) {
  if (fa[x] == x) {
    return x;
  }
  int tmp = fa[x];
  fa[x] = find(fa[x]);
  if (dfn[sdm[mn[tmp]]] < dfn[sdm[mn[x]]]) {
    mn[x] = mn[tmp];
  }
  return fa[x];
}

void getsdom() {
  dfs(1);
  for (int i = 1; i <= n; ++i) {
    mn[i] = fa[i] = sdm[i] = i;
  }
  for (int i = dfc; i >= 2; --i) {
    int u = pos[i], res = INF;
    for (int j = h[1][u]; j; j = e[j].x) {
      int v = e[j].v;
      if (!dfn[v]) {
        continue;
      }
      find(v);
      if (dfn[v] < dfn[u]) {
        res = std::min(res, dfn[v]);
      } else {
        res = std::min(res, dfn[sdm[mn[v]]]);
      }
    }
    sdm[u] = pos[res];
    fa[u] = fth[u];
  }
}
求解直接支配点
转化为 DAG
可是我还是不知道半支配点有什么用!
我们考虑在 上对每一个 加入 的有向边.根据引理 9,新得到的这张图 一定是有向无环图;又根据引理 10,我们还发现这样加边不会改变支配关系,因此我们把原图转化为了一张 DAG,利用上文的算法求解即可.
通过半支配点求解
建一堆图也太不优雅了!
定理 2: 对于任意节点 ,若 上从 到 的路径上的任意节点 都满足 ,则 .
证明: 根据引理 10 我们知道 是 或其祖先,因此只需证明 .
考虑任意一条 到 的路径 ,我们需要证明 一定在 中.令 为 中最后一个满足 的节点.如果 不存在则必有 ,否则令 是 中 之后在 DFS 树中从 到 的路径上的第一个点.
我们接下来证明 .考虑 上 到 的路径 ,若不成立,则存在 .此时一定存在某个 满足 是 的祖先.由 的取值可知 ,于是 也在 DFS 树中从 到 的路径上,与 的定义矛盾,因此 ,结合定理的条件有 ,即路径 包含 .
定理 3: 对于任意节点 , 上从 到 的路径上的所有节点中半支配点最小的节点 一定满足 和 .
证明: 考虑到 本身也满足 的条件,因此 .
由于 是 在 上的祖先,由引理 11 可知 也是 的祖先,因此只需证明 支配 .
考虑任意一条 到 的路径 ,我们需要证明 一定在 中.令 为 中最后一个满足 的节点.如果 不存在则必有 ,否则令 是 中 之后在 DFS 树中从 到 的路径上的第一个点.
与定理 2 的证明过程同理,我们可以得到 .根据引理 10 有 .至此,由 的定义可知 不能是 的后代;另一方面, 不能既是 的后代也是 的祖先,否则沿 DFS 树从 到 再沿 P 走到 ,最后沿 DFS 树走到 的这条路径不经过 ,与支配点的定义矛盾.因此 ,即 包含 .
根据以上两个定理我们能够得到 与 之间的关系.
令 是满足 在 与 之间的结点的所有节点中, 最小的一个节点,那么:
只要对上面求解半支配点的代码稍作修改即可.
struct E {
  int v, x;
} e[MAX * 4];

int h[3][MAX * 2];

int dfc, tot, n, m, u, v;
int fa[MAX], fth[MAX], pos[MAX], mn[MAX], idm[MAX], sdm[MAX], dfn[MAX],
    ans[MAX];

void add(int x, int u, int v) {
  e[++tot] = {v, h[x][u]};
  h[x][u] = tot;
}

void dfs(int u) {
  dfn[u] = ++dfc;
  pos[dfc] = u;
  for (int i = h[0][u]; i; i = e[i].x) {
    int v = e[i].v;
    if (!dfn[v]) {
      dfs(v);
      fth[v] = u;
    }
  }
}

int find(int x) {
  if (fa[x] == x) {
    return x;
  }
  int tmp = fa[x];
  fa[x] = find(fa[x]);
  if (dfn[sdm[mn[tmp]]] < dfn[sdm[mn[x]]]) {
    mn[x] = mn[tmp];
  }
  return fa[x];
}

void tar(int st) {
  dfs(st);
  for (int i = 1; i <= n; ++i) {
    fa[i] = sdm[i] = mn[i] = i;
  }
  for (int i = dfc; i >= 2; --i) {
    int u = pos[i], res = INF;
    for (int j = h[1][u]; j; j = e[j].x) {
      int v = e[j].v;
      if (!dfn[v]) {
        continue;
      }
      find(v);
      if (dfn[v] < dfn[u]) {
        res = std::min(res, dfn[v]);
      } else {
        res = std::min(res, dfn[sdm[mn[v]]]);
      }
    }
    sdm[u] = pos[res];
    fa[u] = fth[u];
    add(2, sdm[u], u);
    u = fth[u];
    for (int j = h[2][u]; j; j = e[j].x) {
      int v = e[j].v;
      find(v);
      if (sdm[mn[v]] == u) {
        idm[v] = u;
      } else {
        idm[v] = mn[v];
      }
    }
    h[2][u] = 0;
  }
  for (int i = 2; i <= dfc; ++i) {
    int u = pos[i];
    if (idm[u] != sdm[u]) {
      idm[u] = idm[idm[u]];
    }
  }
}
例题
洛谷 P5180【模板】支配树
可以仅求解支配关系,求解过程中记录各个点支配了多少节点,也可以建出支配树求解每个节点的 size.
这里给出后一种解法的代码.
参考代码
#include <iostream>
using std::cin;
using std::cout;
constexpr int MAX = 3e5 + 5;
constexpr int INF = 0x5ffffff;

struct E {
  int v, x;
} e[MAX * 4];

int n, m, u, v, tot, dfc;
int ans[MAX], dfn[MAX], pos[MAX], sdm[MAX], idm[MAX], fa[MAX], mn[MAX],
    fth[MAX];
int h[3][MAX * 2];

void add(int x, int u, int v) {
  e[++tot] = {v, h[x][u]};
  h[x][u] = tot;
}

void dfs(int u) {
  dfn[u] = ++dfc;
  pos[dfc] = u;
  for (int i = h[0][u]; i; i = e[i].x) {
    int v = e[i].v;
    if (!dfn[v]) {
      dfs(v);
      fth[v] = u;
    }
  }
}

int find(int x) {
  if (fa[x] == x) {
    return x;
  }
  int tmp = fa[x];
  fa[x] = find(fa[x]);
  if (dfn[sdm[mn[tmp]]] < dfn[sdm[mn[x]]]) {
    mn[x] = mn[tmp];
  }
  return fa[x];
}

void tar(int st) {
  dfs(st);
  for (int i = 1; i <= n; ++i) {
    mn[i] = fa[i] = sdm[i] = i;
  }
  for (int i = dfc; i >= 2; --i) {
    int u = pos[i], res = INF;
    for (int j = h[1][u]; j; j = e[j].x) {
      int v = e[j].v;
      if (!dfn[v]) {
        continue;
      }
      find(v);
      if (dfn[v] < dfn[u]) {
        res = std::min(res, dfn[v]);
      } else {
        res = std::min(res, dfn[sdm[mn[v]]]);
      }
    }
    sdm[u] = pos[res];
    fa[u] = fth[u];
    add(2, sdm[u], u);
    u = fth[u];
    for (int j = h[2][u]; j; j = e[j].x) {
      int v = e[j].v;
      find(v);
      if (u == sdm[mn[v]]) {
        idm[v] = u;
      } else {
        idm[v] = mn[v];
      }
    }
    h[2][u] = 0;
  }
  for (int i = 2; i <= dfc; ++i) {
    int u = pos[i];
    if (idm[u] != sdm[u]) {
      idm[u] = idm[idm[u]];
    }
  }
  for (int i = dfc; i >= 2; --i) {
    ++ans[pos[i]];
    ans[idm[pos[i]]] += ans[pos[i]];
  }
  ++ans[1];
}

int main() {
  cin >> n >> m;
  for (int i = 1; i <= m; ++i) {
    cin >> u >> v;
    add(0, u, v);
    add(1, v, u);
  }
  tar(1);
  for (int i = 1; i <= n; ++i) {
    cout << ans[i] << ' ';
  }
}
ZJOI2012 灾难
在 DAG 上求支配树然后求节点 size 即可.
参考代码
#include <iostream>
#include <stack>
#include <vector>

using std::cin;
using std::cout;
using std::stack;
using std::vector;

constexpr int MAX = 65536;
int n, x, tot;
int d[MAX], w[MAX], siz[MAX], p[MAX], f[MAX][17];
vector<int> e[MAX], g[MAX], h[MAX];
stack<int> s;

void topo() {
  s.push(0);
  for (int i = 1; i <= n; ++i) {
    if (!w[i]) {
      e[0].push_back(i);
      g[i].push_back(0);
      ++w[i];
    }
  }
  while (!s.empty()) {
    int x = s.top();
    s.pop();
    p[++tot] = x;
    for (int i : e[x]) {
      --w[i];
      if (!w[i]) {
        s.push(i);
      }
    }
  }
}

int lca(int u, int v) {
  if (d[u] < d[v]) {
    std::swap(u, v);
  }
  for (int i = 15; i >= 0; --i) {
    if (d[f[u][i]] >= d[v]) {
      u = f[u][i];
    }
  }
  if (u == v) {
    return u;
  }
  for (int i = 15; i >= 0; --i) {
    if (f[u][i] != f[v][i]) {
      u = f[u][i];
      v = f[v][i];
    }
  }
  return f[u][0];
}

void dfs(int x) {
  siz[x] = 1;
  for (int i : h[x]) {
    dfs(i);
    siz[x] += siz[i];
  }
}

void build() {
  for (int i = 2; i <= n + 1; ++i) {
    int x = p[i], y = g[x][0];
    for (int j = 1, q = g[x].size(); j < q; ++j) {
      y = lca(y, g[x][j]);
    }
    h[y].push_back(x);
    d[x] = d[y] + 1;
    f[x][0] = y;
    for (int i = 1; i <= 15; ++i) {
      f[x][i] = f[f[x][i - 1]][i - 1];
    }
  }
}

int main() {
  cin >> n;
  for (int i = 1; i <= n; ++i) {
    while (true) {
      cin >> x;
      if (!x) {
        break;
      }
      e[x].push_back(i);
      g[i].push_back(x);
      ++w[i];
    }
  }
  topo();
  build();
  dfs(0);
  for (int i = 1; i <= n; ++i) {
    cout << siz[i] - 1 << '\n';
  }
  return 0;
}