引入
树状数组是一种支持 单点修改 和 区间查询 的,代码量小的数据结构.
什么是「单点修改」和「区间查询」?
假设有这样一道题:
已知一个数列 a a a
给定 x , y x, y x , y a [ x ] a[x] a [ x ] y y y
给定 l , r l, r l , r a [ l … r ] a[l \ldots r] a [ l … r ]
其中第一种操作就是「单点修改」,第二种操作就是「区间查询」.
类似地,还有:「区间修改」、「单点查询」.它们分别的一个例子如下:
区间修改:给定 l , r , x l, r, x l , r , x a [ l … r ] a[l \ldots r] a [ l … r ] x x x
单点查询:给定 x x x a [ x ] a[x] a [ x ]
注意到,区间问题一般严格强于单点问题,因为对单点的操作相当于对一个长度为 1 1 1
普通树状数组维护的信息及运算要满足 结合律 且 可差分 ,如加法(和)、乘法(积)、异或等.
结合律:( x ∘ y ) ∘ z = x ∘ ( y ∘ z ) (x \circ y) \circ z = x \circ (y \circ z) ( x ∘ y ) ∘ z = x ∘ ( y ∘ z ) ∘ \circ ∘
可差分:具有逆运算的运算,即已知 x ∘ y x \circ y x ∘ y x x x y y y
需要注意的是:
模意义下的乘法若要可差分,需保证每个数都存在逆元(模数为质数时一定存在);
例如 gcd \gcd g cdmax \max max
使用两个树状数组可以用于处理区间最值,见 Efficient Range Minimum Queries using Binary Indexed Trees .
本页面也会介绍一种支持不可差分信息查询的,Θ ( log 2 n ) \Theta(\log^2n) Θ ( log 2 n )
事实上,树状数组能解决的问题是线段树能解决的问题的子集:树状数组能做的,线段树一定能做;线段树能做的,树状数组不一定可以.然而,树状数组的代码要远比线段树短,时间效率常数也更小,因此仍有学习价值.
有时,在差分数组和辅助数组的帮助下,树状数组还可解决更强的 区间加单点值 和 区间加区间和 问题.
树状数组
初步感受
先来举个例子:我们想知道 a [ 1 … 7 ] a[1 \ldots 7] a [ 1 … 7 ]
一种做法是:a 1 + a 2 + a 3 + a 4 + a 5 + a 6 + a 7 a_1 + a_2 + a_3 + a_4 + a_5 + a_6 + a_7 a 1 + a 2 + a 3 + a 4 + a 5 + a 6 + a 7 7 7 7
但是如果已知三个数 A A A B B B C C C A = a [ 1 … 4 ] A = a[1 \ldots 4] A = a [ 1 … 4 ] B = a [ 5 … 6 ] B = a[5 \ldots 6] B = a [ 5 … 6 ] C = a [ 7 … 7 ] C = a[7 \ldots 7] C = a [ 7 … 7 ] a [ 7 ] a[7] a [ 7 ] A + B + C A + B + C A + B + C 3 3 3
这就是树状数组能快速求解信息的原因:我们总能将一段前缀 [ 1 , n ] [1, n] [ 1 , n ] 不多于 log n \boldsymbol{\log n} l o g n ,使得这 log n \log n log n 已知的 .
于是,我们只需合并这 log n \log n log n n n n
不难发现信息必须满足结合律,否则就不能像上面这样合并了.
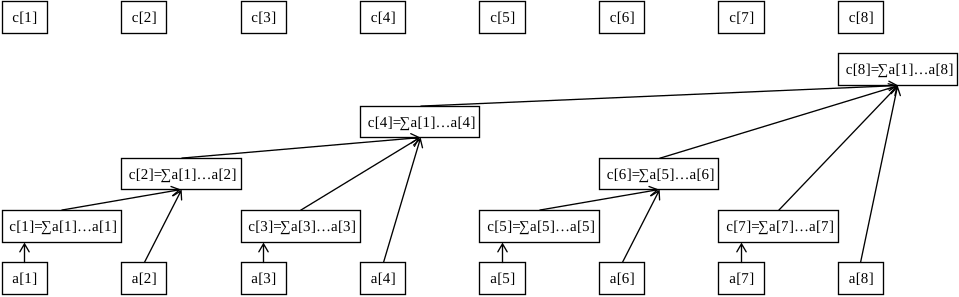
下面这张图展示了树状数组的工作原理:
最下面的八个方块代表原始数据数组 a a a a a a c c c
c c c a a a
例如,从图中可以看出:
c 2 c_2 c 2 a [ 1 … 2 ] a[1 \ldots 2] a [ 1 … 2 ] c 4 c_4 c 4 a [ 1 … 4 ] a[1 \ldots 4] a [ 1 … 4 ] c 6 c_6 c 6 a [ 5 … 6 ] a[5 \ldots 6] a [ 5 … 6 ] c 8 c_8 c 8 a [ 1 … 8 ] a[1 \ldots 8] a [ 1 … 8 ] 剩下的 c [ x ] c[x] c [ x ] a [ x ] a[x] a [ x ] a [ x … x ] a[x \ldots x] a [ x … x ] 1 1 1
不难发现,c [ x ] c[x] c [ x ] x x x
举例:计算 a [ 1 … 7 ] a[1 \ldots 7] a [ 1 … 7 ]
过程:从 c 7 c_{7} c 7 c 7 c_{7} c 7 a 7 a_{7} a 7 c 6 c_{6} c 6 c 6 c_{6} c 6 a [ 5 … 6 ] a[5 \ldots 6] a [ 5 … 6 ] c 4 c_{4} c 4 c 4 c_{4} c 4 a [ 1 … 4 ] a[1 \ldots 4] a [ 1 … 4 ] c 0 c_0 c 0 c 0 c_0 c 0
我们刚刚找到的 c c c c 7 , c 6 , c 4 c_7, c_6, c_4 c 7 , c 6 , c 4 a [ 1 … 7 ] a[1 \ldots 7] a [ 1 … 7 ] c 7 + c 6 + c 4 c_7 + c_6 + c_4 c 7 + c 6 + c 4
举例:计算 a [ 4 … 7 ] a[4 \ldots 7] a [ 4 … 7 ]
我们还是从 c 7 c_7 c 7 c 6 c_6 c 6 c 4 c_4 c 4 a [ 1 … 4 ] a[1 \ldots 4] a [ 1 … 4 ] a [ 1 … 3 ] a[1 \ldots 3] a [ 1 … 3 ] a [ 1 … 3 ] a[1 \ldots 3] a [ 1 … 3 ]
那不妨考虑最开始,就将查询 a [ 4 … 7 ] a[4 \ldots 7] a [ 4 … 7 ] a [ 1 … 7 ] a[1 \ldots 7] a [ 1 … 7 ] a [ 1 … 3 ] a[1 \ldots 3] a [ 1 … 3 ]
管辖区间
那么问题来了,c [ x ] ( x ≥ 1 ) c[x](x \ge 1) c [ x ] ( x ≥ 1 )
树状数组中,规定 c [ x ] c[x] c [ x ] 2 k 2^{k} 2 k
设二进制最低位为第 0 0 0 k k k x x x 1 所在的二进制位数;
2 k 2^k 2 k c [ x ] c[x] c [ x ] x x x 1 以及后面所有 0 组成的数.
举个例子,c 88 c_{88} c 88
因为 88 ( 10 ) = 01011000 ( 2 ) 88_{(10)}=01011000_{(2)} 8 8 ( 10 ) = 0101100 0 ( 2 ) 1 以及后面的 0 组成的二进制是 1000,即 8 8 8 c 88 c_{88} c 88 8 8 8 a a a
因此,c 88 c_{88} c 88 a [ 81 … 88 ] a[81 \ldots 88] a [ 81 … 88 ]
我们记 x x x 1 以及后面的 0 组成的数为 lowbit ( x ) \operatorname{lowbit}(x) lowbit ( x ) c [ x ] c[x] c [ x ] [ x − lowbit ( x ) + 1 , x ] [x-\operatorname{lowbit}(x)+1, x] [ x − lowbit ( x ) + 1 , x ]
注意
lowbit \operatorname{lowbit} lowbit 1 所在的位数 k k k 1 和后面所有 0 组成的 2 k 2^k 2 k
怎么计算 lowbit?根据位运算知识,可以得到 lowbit(x) = x & -x.
lowbit 的原理
将 x 的二进制所有位全部取反,再加 1,就可以得到 -x 的二进制编码.例如,6 6 6 110,全部取反后得到 001,加 1 得到 010.
设原先 x 的二进制编码是 (...)10...00,全部取反后得到 [...]01...11,加 1 后得到 [...]10...00,也就是 -x 的二进制编码了.这里 x 二进制表示中第一个 1 是 x 最低位的 1.
(...) 和 [...] 中省略号的每一位分别相反,所以 x & -x = (...)10...00 & [...]10...00 = 10...00,得到的结果就是 lowbit.
实现
C++
int lowbit (int x) return x & -x;
}
Python
def lowbit (x ):
"""
x 的二进制中,最低位的 1 以及后面所有 0 组成的数.
lowbit(0b01011000) == 0b00001000
~~~~~^~~
lowbit(0b01110010) == 0b00000010
~~~~~~~^~
"""
return x & -x
区间查询
接下来我们来看树状数组具体的操作实现,先来看区间查询.
回顾查询 a [ 4 … 7 ] a[4 \ldots 7] a [ 4 … 7 ] a [ 1 … 7 ] a[1 \ldots 7] a [ 1 … 7 ] a [ 1 … 3 ] a[1 \ldots 3] a [ 1 … 3 ]
其实任何一个区间查询都可以这么做:查询 a [ l … r ] a[l \ldots r] a [ l … r ] a [ 1 … r ] a[1 \ldots r] a [ 1 … r ] a [ 1 … l − 1 ] a[1 \ldots l - 1] a [ 1 … l − 1 ]
事实上,将有关 l … r l \ldots r l … r 1 … r 1 \ldots r 1 … r 1 … l − 1 1 \ldots l - 1 1 … l − 1
那前缀查询怎么做呢?回顾下查询 a [ 1 … 7 ] a[1 \ldots 7] a [ 1 … 7 ]
从 c 7 c_{7} c 7 c 7 c_{7} c 7 a 7 a_{7} a 7 c 6 c_{6} c 6 c 6 c_{6} c 6 a [ 5 … 6 ] a[5 \ldots 6] a [ 5 … 6 ] c 4 c_{4} c 4 c 4 c_{4} c 4 a [ 1 … 4 ] a[1 \ldots 4] a [ 1 … 4 ] c 0 c_0 c 0 c 0 c_0 c 0
我们刚刚找到的 c c c c 7 , c 6 , c 4 c_7, c_6, c_4 c 7 , c 6 , c 4 a [ 1 … 7 ] a[1 \ldots 7] a [ 1 … 7 ] c 7 + c 6 + c 4 c_7 + c_6 + c_4 c 7 + c 6 + c 4
观察上面的过程,每次往前跳,一定是跳到现区间的左端点的左一位,作为新区间的右端点,这样才能将前缀不重不漏地拆分.比如现在 c 6 c_6 c 6 a [ 5 … 6 ] a[5 \ldots 6] a [ 5 … 6 ] 5 − 1 = 4 5 - 1 = 4 5 − 1 = 4 c 4 c_4 c 4
我们可以写出查询 a [ 1 … x ] a[1 \ldots x] a [ 1 … x ]
从 c [ x ] c[x] c [ x ] c [ x ] c[x] c [ x ] a [ x − lowbit ( x ) + 1 … x ] a[x-\operatorname{lowbit}(x)+1 \ldots x] a [ x − lowbit ( x ) + 1 … x ]
令 x ← x − lowbit ( x ) x \gets x - \operatorname{lowbit}(x) x ← x − lowbit ( x ) x = 0 x = 0 x = 0
将跳到的 c c c
实现时,我们不一定要先把 c c c
比如我们要维护的信息是和,直接令初始 a n s = 0 \mathrm{ans} = 0 ans = 0 c [ x ] c[x] c [ x ] a n s ← a n s + c [ x ] \mathrm{ans} \gets \mathrm{ans} + c[x] ans ← ans + c [ x ] a n s \mathrm{ans} ans
实现
C++
int getsum (int x) int ans = 0 ;
while (x > 0 ) {
ans = ans + c[x];
x = x - lowbit (x);
}
return ans;
}
Python
def getsum (x ):
ans = 0
while x > 0 :
ans = ans + c[x]
x = x - lowbit(x)
return ans
树状数组与其树形态的性质
在讲解单点修改之前,先讲解树状数组的一些基本性质,以及其树形态来源,这有助于更好理解树状数组的单点修改.
我们约定:
l ( x ) = x − lowbit ( x ) + 1 l(x) = x - \operatorname{lowbit}(x) + 1 l ( x ) = x − lowbit ( x ) + 1 l ( x ) l(x) l ( x ) c [ x ] c[x] c [ x ] 对于任意正整数 x x x x x x s × 2 k + 1 + 2 k s \times 2^{k + 1} + 2^k s × 2 k + 1 + 2 k lowbit ( x ) = 2 k \operatorname{lowbit}(x) = 2^k lowbit ( x ) = 2 k
下面「c [ x ] c[x] c [ x ] c [ y ] c[y] c [ y ] c [ x ] c[x] c [ x ] c [ y ] c[y] c [ y ] [ l ( x ) , x ] [l(x), x] [ l ( x ) , x ] [ l ( y ) , y ] [l(y), y] [ l ( y ) , y ] c [ x ] c[x] c [ x ] c [ y ] c[y] c [ y ]
性质 1 \boldsymbol{1} 1 x ≤ y \boldsymbol{x \le y} x ≤ y c [ x ] \boldsymbol{c[x]} c [ x ] c [ y ] \boldsymbol{c[y]} c [ y ] c [ x ] \boldsymbol{c[x]} c [ x ] c [ y ] \boldsymbol{c[y]} c [ y ]
证明
证明:假设 c [ x ] c[x] c [ x ] c [ y ] c[y] c [ y ] [ l ( x ) , x ] [l(x), x] [ l ( x ) , x ] [ l ( y ) , y ] [l(y), y] [ l ( y ) , y ] l ( y ) ≤ x ≤ y l(y) \le x \le y l ( y ) ≤ x ≤ y
将 y y y s × 2 k + 1 + 2 k s \times 2^{k +1} + 2^k s × 2 k + 1 + 2 k l ( y ) = s × 2 k + 1 + 1 l(y) = s \times 2^{k + 1} + 1 l ( y ) = s × 2 k + 1 + 1 x x x s × 2 k + 1 + b s \times 2^{k +1} + b s × 2 k + 1 + b 1 ≤ b ≤ 2 k 1 \le b \le 2^k 1 ≤ b ≤ 2 k
不难发现 lowbit ( x ) = lowbit ( b ) \operatorname{lowbit}(x) = \operatorname{lowbit}(b) lowbit ( x ) = lowbit ( b ) b − lowbit ( b ) ≥ 0 b - \operatorname{lowbit}(b) \ge 0 b − lowbit ( b ) ≥ 0
所以 l ( x ) = x − lowbit ( x ) + 1 = s × 2 k + 1 + b − lowbit ( b ) + 1 ≥ s × 2 k + 1 + 1 = l ( y ) l(x) = x - \operatorname{lowbit}(x) + 1 = s \times 2^{k +1} + b - \operatorname{lowbit}(b) +1 \ge s \times 2^{k +1} + 1 = l(y) l ( x ) = x − lowbit ( x ) + 1 = s × 2 k + 1 + b − lowbit ( b ) + 1 ≥ s × 2 k + 1 + 1 = l ( y ) l ( y ) ≤ l ( x ) ≤ x ≤ y l(y) \le l(x) \le x \le y l ( y ) ≤ l ( x ) ≤ x ≤ y
所以,如果 c [ x ] c[x] c [ x ] c [ y ] c[y] c [ y ] c [ x ] c[x] c [ x ] c [ y ] c[y] c [ y ]
性质 2 \boldsymbol{2} 2 c [ x ] \boldsymbol{c[x]} c [ x ] c [ x + lowbit ( x ) ] \boldsymbol{c[x + \operatorname{lowbit}(x)]} c [ x + lowbit ( x )]
证明
证明:设 y = x + lowbit ( x ) y = x + \operatorname{lowbit}(x) y = x + lowbit ( x ) x = s × 2 k + 1 + 2 k x = s \times 2^{k + 1} + 2^k x = s × 2 k + 1 + 2 k y = ( s + 1 ) × 2 k + 1 y = (s + 1) \times 2^{k +1} y = ( s + 1 ) × 2 k + 1 l ( x ) = s × 2 k + 1 + 1 l(x) = s \times 2^{k + 1} + 1 l ( x ) = s × 2 k + 1 + 1
不难发现 lowbit ( y ) ≥ 2 k + 1 \operatorname{lowbit}(y) \ge 2^{k + 1} lowbit ( y ) ≥ 2 k + 1 l ( y ) = ( s + 1 ) × 2 k + 1 − lowbit ( y ) + 1 ≤ s × 2 k + 1 + 1 = l ( x ) l(y) = (s + 1) \times 2^{k + 1} - \operatorname{lowbit}(y) + 1 \le s \times 2^{k +1} + 1= l(x) l ( y ) = ( s + 1 ) × 2 k + 1 − lowbit ( y ) + 1 ≤ s × 2 k + 1 + 1 = l ( x ) l ( y ) ≤ l ( x ) ≤ x < y l(y) \le l(x) \le x < y l ( y ) ≤ l ( x ) ≤ x < y
所以,c [ x ] c[x] c [ x ] c [ x + lowbit ( x ) ] c[x + \operatorname{lowbit}(x)] c [ x + lowbit ( x )]
性质 3 3 3 x < y < x + lowbit ( x ) \boldsymbol{x < y < x + \operatorname{lowbit}(x)} x < y < x + lowbit ( x ) c [ x ] \boldsymbol{c[x]} c [ x ] c [ y ] \boldsymbol{c[y]} c [ y ]
证明
证明:设 x = s × 2 k + 1 + 2 k x = s \times 2^{k + 1} + 2^k x = s × 2 k + 1 + 2 k y = x + b = s × 2 k + 1 + 2 k + b y = x + b = s \times 2^{k + 1} + 2^k + b y = x + b = s × 2 k + 1 + 2 k + b 1 ≤ b < 2 k 1 \le b < 2^k 1 ≤ b < 2 k
不难发现 lowbit ( y ) = lowbit ( b ) \operatorname{lowbit}(y) = \operatorname{lowbit}(b) lowbit ( y ) = lowbit ( b ) b − lowbit ( b ) ≥ 0 b - \operatorname{lowbit}(b) \ge 0 b − lowbit ( b ) ≥ 0
因此 l ( y ) = y − lowbit ( y ) + 1 = x + b − lowbit ( b ) + 1 > x l(y) = y - \operatorname{lowbit}(y) + 1 = x + b - \operatorname{lowbit}(b) + 1 > x l ( y ) = y − lowbit ( y ) + 1 = x + b − lowbit ( b ) + 1 > x l ( x ) ≤ x < l ( y ) ≤ y l(x) \le x < l(y) \le y l ( x ) ≤ x < l ( y ) ≤ y
所以,c [ x ] c[x] c [ x ] c [ y ] c[y] c [ y ]
有了这三条性质的铺垫,我们接下来看树状数组的树形态(请忽略 a a a c c c
事实上,树状数组的树形态是 x x x x + lowbit ( x ) x + \operatorname{lowbit}(x) x + lowbit ( x ) x + lowbit ( x ) x + \operatorname{lowbit}(x) x + lowbit ( x ) x x x
注意,在考虑树状数组的树形态时,我们不考虑树状数组大小的影响,即我们认为这是一棵无限大的树,方便分析.实际实现时,我们只需用到 x ≤ n x \le n x ≤ n c [ x ] c[x] c [ x ] n n n
这棵树天然满足了很多美好性质,下面列举若干(设 f a [ u ] fa[u] f a [ u ] u u u
u < f a [ u ] u < fa[u] u < f a [ u ] u u u u u u u u u 点 u u u lowbit \operatorname{lowbit} lowbit f a [ u ] fa[u] f a [ u ] lowbit \operatorname{lowbit} lowbit
证明
设 y = x + lowbit ( x ) y = x + \operatorname{lowbit}(x) y = x + lowbit ( x ) x = s × 2 k + 1 + 2 k x = s \times 2^{k + 1} + 2^k x = s × 2 k + 1 + 2 k y = ( s + 1 ) × 2 k + 1 y = (s + 1) \times 2^{k +1} y = ( s + 1 ) × 2 k + 1 lowbit ( y ) ≥ 2 k + 1 > lowbit ( x ) \operatorname{lowbit}(y) \ge 2^{k + 1} > \operatorname{lowbit}(x) lowbit ( y ) ≥ 2 k + 1 > lowbit ( x )
点 x x x log 2 lowbit ( x ) \log_2\operatorname{lowbit}(x) log 2 lowbit ( x ) x x x 1 的位数.
高度的定义
点 x x x h ( x ) h(x) h ( x ) x m o d 2 = 1 x \bmod 2 = 1 x mod 2 = 1 h ( x ) = 0 h(x) = 0 h ( x ) = 0 h ( x ) = max ( h ( y ) ) + 1 h(x) = \max(h(y)) + 1 h ( x ) = max ( h ( y )) + 1 y y y x x x x x x x − 1 x - 1 x − 1
也就是说,一个点的高度恰好比它最高的那个儿子再高 1 1 1 0 0 0
这里引出高度这一概念,是为后面解释复杂度更方便.
c [ u ] c[u] c [ u ] c [ f a [ u ] ] c[fa[u]] c [ f a [ u ]] 2 2 2 c [ u ] c[u] c [ u ] c [ v ] c[v] c [ v ] v v v u u u c [ u ] c[u] c [ u ] c [ v ] c[v] c [ v ] v v v u u u u u u v v v 对于任意 v ′ > u v' > u v ′ > u v ′ v' v ′ u u u c [ u ] c[u] c [ u ] c [ v ′ ] c[v'] c [ v ′ ]
证明
u u u u u u v v v v < v ′ < f a [ v ] v < v' < fa[v] v < v ′ < f a [ v ] 3 3 3 c [ v ′ ] c[v'] c [ v ′ ] c [ v ] c[v] c [ v ] c [ v ] c[v] c [ v ] c [ u ] c[u] c [ u ] c [ v ′ ] c[v'] c [ v ′ ] c [ u ] c[u] c [ u ]
对于任意 v < u v < u v < u v v v u u u c [ u ] c[u] c [ u ] c [ v ] c[v] c [ v ] u u u v ′ v' v ′
对于任意 v > u v > u v > u v v v u u u c [ u ] c[u] c [ u ] c [ v ] c[v] c [ v ]
设 u = s × 2 k + 1 + 2 k u = s \times 2^{k + 1} + 2^k u = s × 2 k + 1 + 2 k k = log 2 lowbit ( u ) k = \log_2\operatorname{lowbit}(u) k = log 2 lowbit ( u ) u − 2 t ( 0 ≤ t < k ) u - 2^t(0 \le t < k) u − 2 t ( 0 ≤ t < k )
举例:假设 k = 3 k = 3 k = 3 u u u ...1000,则 u u u ...0111、...0110、...0100.
证明
在一个数 x x x 2 t 2^t 2 t x x x t t t
考虑 u u u v v v v + lowbit ( v ) = u v + \operatorname{lowbit}(v) = u v + lowbit ( v ) = u v = u − 2 t v = u - 2^t v = u − 2 t lowbit ( v ) = 2 t \operatorname{lowbit}(v) = 2^t lowbit ( v ) = 2 t u = s × 2 k + 1 + 2 k u = s \times 2^{k + 1} + 2^k u = s × 2 k + 1 + 2 k
考虑 0 ≤ t < k \boldsymbol{0 \le t < k} 0 ≤ t < k ,u u u t t t 0 0 0 v = u − 2 t v = u - 2^t v = u − 2 t t t t 1 1 1 0 0 0 满足 lowbit ( v ) = 2 t \operatorname{lowbit}(v) = 2^t lowbit ( v ) = 2 t
考虑 t = k \boldsymbol{t = k} t = k ,则 v = u − 2 k v = u - 2^k v = u − 2 k v v v k k k 0 0 0 不满足 lowbit ( v ) = 2 t \operatorname{lowbit}(v) = 2^t lowbit ( v ) = 2 t
考虑 t > k \boldsymbol{t > k} t > k ,则 v = u − 2 t v = u - 2^t v = u − 2 t v v v k k k 1 1 1 lowbit ( v ) = 2 k \operatorname{lowbit}(v) = 2^k lowbit ( v ) = 2 k 不满足 lowbit ( v ) = 2 t \operatorname{lowbit}(v) = 2^t lowbit ( v ) = 2 t
u u u c c c [ l ( u ) , u − 1 ] [l(u), u - 1] [ l ( u ) , u − 1 ]
举例:假设 k = 3 k = 3 k = 3 u u u ...1000,则 u u u ...0111、...0110、...0100.
c[...0100] 表示 a[...0001 ~ ...0100].c[...0110] 表示 a[...0101 ~ ...0110].c[...0111] 表示 a[...0111 ~ ...0111].不难发现上面是三个管辖区间的并集恰好是 a[...0001 ~ ...0111],即 [ l ( u ) , u − 1 ] [l(u), u - 1] [ l ( u ) , u − 1 ]
证明
u u u u − 2 t ( 0 ≤ t < k ) u - 2^t(0 \le t < k) u − 2 t ( 0 ≤ t < k ) t t t u − 2 t u - 2^t u − 2 t f ( t ) = u − 2 t f(t) = u - 2^t f ( t ) = u − 2 t f ( k − 1 ) , f ( k − 2 ) , … , f ( 0 ) f(k - 1), f(k - 2), \ldots, f(0) f ( k − 1 ) , f ( k − 2 ) , … , f ( 0 ) u u u
不难发现 lowbit ( f ( t ) ) = 2 t \operatorname{lowbit}(f(t)) = 2^t lowbit ( f ( t )) = 2 t l ( f ( t ) ) = u − 2 t − 2 t + 1 = u − 2 t + 1 + 1 l(f(t)) = u - 2^t - 2^t + 1 = u - 2^{t + 1} + 1 l ( f ( t )) = u − 2 t − 2 t + 1 = u − 2 t + 1 + 1
考虑相邻的两个儿子 f ( t + 1 ) f(t + 1) f ( t + 1 ) f ( t ) f(t) f ( t ) f ( t + 1 ) = u − 2 t + 1 f(t + 1) = u - 2^{t + 1} f ( t + 1 ) = u − 2 t + 1 l ( f ( t ) ) = u − 2 t + 1 + 1 l(f(t)) = u - 2^{t + 1} + 1 l ( f ( t )) = u − 2 t + 1 + 1
考虑最左面的儿子 f ( k − 1 ) f(k - 1) f ( k − 1 ) l ( f ( k − 1 ) ) = u − 2 k + 1 l(f(k - 1)) = u - 2^k + 1 l ( f ( k − 1 )) = u − 2 k + 1 l ( u ) l(u) l ( u )
考虑最右面的儿子 f ( 0 ) f(0) f ( 0 ) u − 1 u - 1 u − 1
因此,这些儿子的管辖区间可以恰好拼成 [ l ( u ) , u − 1 ] [l(u), u - 1] [ l ( u ) , u − 1 ]
单点修改
现在来考虑如何单点修改 a [ x ] a[x] a [ x ]
我们的目标是快速正确地维护 c c c a [ x ] a[x] a [ x ] c [ y ] c[y] c [ y ] c c c
管辖 a [ x ] a[x] a [ x ] c [ y ] c[y] c [ y ] c [ x ] c[x] c [ x ] 1 1 1 y y y x x x x x x
设 n n n a a a a [ x ] a[x] a [ x ]
初始令 x ′ = x x' = x x ′ = x
修改 c [ x ′ ] c[x'] c [ x ′ ]
令 x ′ ← x ′ + lowbit ( x ′ ) x' \gets x' + \operatorname{lowbit}(x') x ′ ← x ′ + lowbit ( x ′ ) x ′ > n x' > n x ′ > n
区间信息和单点修改的种类,共同决定 c [ x ′ ] c[x'] c [ x ′ ]
若 c [ x ′ ] c[x'] c [ x ′ ] a [ x ] a[x] a [ x ] p p p c [ x ′ ] c[x'] c [ x ′ ] p p p
若 c [ x ′ ] c[x'] c [ x ′ ] a [ x ] a[x] a [ x ] p p p c [ x ′ ] c[x'] c [ x ′ ] p p p
然而,单点修改的自由性使得修改的种类和维护的信息不一定是同种运算,比如,若 c [ x ′ ] c[x'] c [ x ′ ] a [ x ] a[x] a [ x ] p p p a [ x ] a[x] a [ x ] p − a [ x ] p - a[x] p − a [ x ] a [ x ] a[x] a [ x ] p p p a [ x ] a[x] a [ x ] a [ x ] × p − a [ x ] a[x] \times p - a[x] a [ x ] × p − a [ x ]
下面以维护区间和,单点加为例给出实现.
实现
C++
void add (int x, int k) while (x <= n) {
c[x] = c[x] + k;
x = x + lowbit (x);
}
}
Python
def add (x, k ):
while x <= n:
c[x] = c[x] + k
x = x + lowbit(x)
建树
也就是根据最开始给出的序列,将树状数组建出来(c c c
一般可以直接转化为 n n n Θ ( n log n ) \Theta(n \log n) Θ ( n log n )
比如给定序列 a = ( 5 , 1 , 4 ) a = (5, 1, 4) a = ( 5 , 1 , 4 ) a [ 1 ] a[1] a [ 1 ] 5 5 5 a [ 2 ] a[2] a [ 2 ] 1 1 1 a [ 3 ] a[3] a [ 3 ] 4 4 4
也有 Θ ( n ) \Theta(n) Θ ( n ) Θ ( n ) \Theta(n) Θ ( n )
复杂度分析
空间复杂度显然 Θ ( n ) \Theta(n) Θ ( n )
时间复杂度:
对于区间查询操作:整个 x ← x − lowbit ( x ) x \gets x - \operatorname{lowbit}(x) x ← x − lowbit ( x ) x x x 1 1 1 0 0 0 x x x 1 1 1 popcount ( x ) \operatorname{popcount}(x) popcount ( x ) Θ ( log n ) \Theta(\log n) Θ ( log n )
对于单点修改操作:跳父亲时,访问到的高度一直严格增加,且始终有 x ≤ n x \le n x ≤ n x x x log 2 lowbit ( x ) \log_2\operatorname{lowbit}(x) log 2 lowbit ( x ) log 2 n \log_2n log 2 n c c c log n \log n log n Θ ( log n ) \Theta(\log n) Θ ( log n )
区间加区间和
前置知识:前缀和 & 差分 .
该问题可以使用两个树状数组维护差分数组解决.
考虑序列 a a a d d d d [ i ] = a [ i ] − a [ i − 1 ] d[i] = a[i] - a[i - 1] d [ i ] = a [ i ] − a [ i − 1 ] a i = ∑ j = 1 i d j a_i=\sum_{j=1}^i d_j a i = ∑ j = 1 i d j
一样地,我们考虑将查询区间和通过差分转化为查询前缀和.那么考虑查询 a [ 1 … r ] a[1 \ldots r] a [ 1 … r ] ∑ i = 1 r a i \sum_{i=1}^{r} a_i ∑ i = 1 r a i
∑ i = 1 r a i = ∑ i = 1 r ∑ j = 1 i d j \begin{aligned}
&\sum_{i=1}^{r} a_i\\=&\sum_{i=1}^r\sum_{j=1}^i d_j
\end{aligned} = i = 1 ∑ r a i i = 1 ∑ r j = 1 ∑ i d j 观察这个式子,不难发现每个 d j d_j d j r − j + 1 r - j + 1 r − j + 1
∑ i = 1 r ∑ j = 1 i d j = ∑ i = 1 r d i × ( r − i + 1 ) = ∑ i = 1 r d i × ( r + 1 ) − ∑ i = 1 r d i × i \begin{aligned}
&\sum_{i=1}^r\sum_{j=1}^i d_j\\=&\sum_{i=1}^r d_i\times(r-i+1)
\\=&\sum_{i=1}^r d_i\times (r+1)-\sum_{i=1}^r d_i\times i
\end{aligned} = = i = 1 ∑ r j = 1 ∑ i d j i = 1 ∑ r d i × ( r − i + 1 ) i = 1 ∑ r d i × ( r + 1 ) − i = 1 ∑ r d i × i ∑ i = 1 r d i \sum_{i=1}^r d_i ∑ i = 1 r d i ∑ i = 1 r d i × i \sum_{i=1}^r d_i \times i ∑ i = 1 r d i × i d i d_i d i d i × i d_i \times i d i × i
那么怎么做区间加呢?考虑给原数组 a [ l … r ] a[l \ldots r] a [ l … r ] x x x d d d
因为差分是 d [ i ] = a [ i ] − a [ i − 1 ] d[i] = a[i] - a[i - 1] d [ i ] = a [ i ] − a [ i − 1 ]
a [ l ] a[l] a [ l ] v v v a [ l − 1 ] a[l - 1] a [ l − 1 ] d [ l ] d[l] d [ l ] v v v a [ r + 1 ] a[r + 1] a [ r + 1 ] a [ r ] a[r] a [ r ] v v v d [ r + 1 ] d[r + 1] d [ r + 1 ] v v v 对于不等于 l l l r + 1 r+1 r + 1 i i i a [ i ] a[i] a [ i ] a [ i − 1 ] a[i - 1] a [ i − 1 ] v v v a [ i ] + v − ( a [ i − 1 ] + v ) a[i] + v - (a[i - 1] + v) a [ i ] + v − ( a [ i − 1 ] + v ) a [ i ] − a [ i − 1 ] a[i] - a[i - 1] a [ i ] − a [ i − 1 ] d [ i ] d[i] d [ i ]
那就不难想到维护方式了:对于维护 d i d_i d i l l l v v v r + 1 r + 1 r + 1 − v -v − v d i × i d_i \times i d i × i l l l v × l v \times l v × l r + 1 r + 1 r + 1 − v × ( r + 1 ) -v \times (r + 1) − v × ( r + 1 )
而更弱的问题,「区间加求单点值」,只需用树状数组维护一个差分数组 d i d_i d i a [ x ] a[x] a [ x ] d [ 1 … x ] d[1 \ldots x] d [ 1 … x ]
这里直接给出「区间加区间和」的代码:
实现
C++
int t1[MAXN], t2[MAXN], n;
int lowbit (int x) return x & (-x); }
void add (int k, int v) int v1 = k * v;
while (k <= n) {
t1[k] += v, t2[k] += v1;
k += lowbit (k);
}
}
int getsum (int *t, int k) int ret = 0 ;
while (k) {
ret += t[k];
k -= lowbit (k);
}
return ret;
}
void add1 (int l, int r, int v) add (l, v), add (r + 1 , -v);
}
long long getsum1 (int l, int r) return (r + 1ll ) * getsum (t1, r) - 1ll * l * getsum (t1, l - 1 ) -
(getsum (t2, r) - getsum (t2, l - 1 ));
}
Python
t1 = [0 ] * MAXN
t2 = [0 ] * MAXN
n = 0
def lowbit (x ):
return x & (-x)
def add (k, v ):
v1 = k * v
while k <= n:
t1[k] = t1[k] + v
t2[k] = t2[k] + v1
k = k + lowbit(k)
def getsum (t, k ):
ret = 0
while k:
ret = ret + t[k]
k = k - lowbit(k)
return ret
def add1 (l, r, v ):
add(l, v)
add(r + 1 , -v)
def getsum1 (l, r ):
return (
(r) * getsum(t1, r)
- l * getsum(t1, l - 1 )
- (getsum(t2, r) - getsum(t2, l - 1 ))
)
根据这个原理,应该可以实现「区间乘区间积」,「区间异或一个数,求区间异或值」等,只要满足维护的信息和区间操作是同种运算即可,感兴趣的读者可以自己尝试.
二维树状数组
单点修改,子矩阵查询
二维树状数组,也被称作树状数组套树状数组,用来维护二维数组上的单点修改和前缀信息问题.
与一维树状数组类似,我们用 c ( x , y ) c(x, y) c ( x , y ) a ( x − lowbit ( x ) + 1 , y − lowbit ( y ) + 1 ) … a ( x , y ) a(x - \operatorname{lowbit}(x) + 1, y - \operatorname{lowbit}(y) + 1) \ldots a(x, y) a ( x − lowbit ( x ) + 1 , y − lowbit ( y ) + 1 ) … a ( x , y ) a ( x , y ) a(x, y) a ( x , y ) lowbit ( x ) \operatorname{lowbit}(x) lowbit ( x ) lowbit ( y ) \operatorname{lowbit}(y) lowbit ( y )
对于单点修改,设:
f ( x , i ) = { x i = 0 f ( x , i − 1 ) + lowbit ( f ( x , i − 1 ) ) i > 0 f(x, i) = \begin{cases}x &i = 0\\f(x, i - 1) + \operatorname{lowbit}(f(x, i - 1)) & i > 0\\\end{cases} f ( x , i ) = { x f ( x , i − 1 ) + lowbit ( f ( x , i − 1 )) i = 0 i > 0 即 f ( x , i ) f(x, i) f ( x , i ) x x x i i i 0 0 0
则只有 c ( f ( x , i ) , f ( y , j ) ) c(f(x, i), f(y, j)) c ( f ( x , i ) , f ( y , j )) a ( x , y ) a(x, y) a ( x , y ) a ( x , y ) a(x, y) a ( x , y ) c ( f ( x , i ) , f ( y , j ) ) c(f(x, i), f(y, j)) c ( f ( x , i ) , f ( y , j )) f ( x , i ) ≤ n f(x, i) \le n f ( x , i ) ≤ n f ( y , j ) ≤ m f(y, j) \le m f ( y , j ) ≤ m
正确性证明
c ( p , q ) c(p, q) c ( p , q ) a ( x , y ) a(x, y) a ( x , y ) p p p q q q
考虑一个大小为 n n n c 1 c_1 c 1 a 1 a_1 a 1 m m m c 2 c_2 c 2 a 2 a_2 a 2
则命题等价为:c 1 ( p ) c_1(p) c 1 ( p ) a 1 [ x ] a_1[x] a 1 [ x ] c 2 ( q ) c_2(q) c 2 ( q ) a 2 [ y ] a_2[y] a 2 [ y ]
也就是说,在树状数组树形态上,p p p x x x q q q y y y
所以 p = f ( x , i ) p = f(x, i) p = f ( x , i ) q = f ( y , j ) q = f(y, j) q = f ( y , j )
对于查询,我们设:
g ( x , i ) = { x i = 0 g ( x , i − 1 ) − lowbit ( g ( x , i − 1 ) ) i , g ( x , i − 1 ) > 0 0 otherwise. g(x, i) = \begin{cases}x &i = 0\\g(x, i - 1) - \operatorname{lowbit}(g(x, i - 1)) & i, g(x, i - 1) > 0\\0&\text{otherwise.}\end{cases} g ( x , i ) = ⎩ ⎨ ⎧ x g ( x , i − 1 ) − lowbit ( g ( x , i − 1 )) 0 i = 0 i , g ( x , i − 1 ) > 0 otherwise. 则合并所有 c ( g ( x , i ) , g ( y , j ) ) c(g(x, i), g(y, j)) c ( g ( x , i ) , g ( y , j )) g ( x , i ) , g ( y , j ) > 0 g(x, i), g(y, j) > 0 g ( x , i ) , g ( y , j ) > 0
正确性证明
设 ∘ \circ ∘ ∘ = + \circ = + ∘ = +
考虑一个一维树状数组 c 1 c_1 c 1 c 1 [ g ( x , 0 ) ] ∘ c 1 [ g ( x , 1 ) ] ∘ c 1 [ g ( x , 2 ) ] ∘ ⋯ c_1[g(x, 0)] \circ c_1[g(x, 1)] \circ c_1[g(x, 2)] \circ \cdots c 1 [ g ( x , 0 )] ∘ c 1 [ g ( x , 1 )] ∘ c 1 [ g ( x , 2 )] ∘ ⋯ [ 1 … x ] [1 \ldots x] [ 1 … x ]
类似地,设 t ( x ) = c ( x , g ( y , 0 ) ) ∘ c ( x , g ( y , 1 ) ) ∘ c ( x , g ( y , 2 ) ) ∘ ⋯ t(x) = c(x, g(y, 0)) \circ c(x, g(y, 1)) \circ c(x, g(y, 2)) \circ \cdots t ( x ) = c ( x , g ( y , 0 )) ∘ c ( x , g ( y , 1 )) ∘ c ( x , g ( y , 2 )) ∘ ⋯ t ( x ) t(x) t ( x ) a ( x − lowbit ( x ) + 1 , 1 ) … a ( x , y ) a(x - \operatorname{lowbit}(x) + 1, 1) \ldots a(x, y) a ( x − lowbit ( x ) + 1 , 1 ) … a ( x , y )
又类似地,就有 t ( g ( x , 0 ) ) ∘ t ( g ( x , 1 ) ) ∘ t ( g ( x , 2 ) ) ∘ ⋯ t(g(x, 0)) \circ t(g(x, 1)) \circ t(g(x, 2)) \circ \cdots t ( g ( x , 0 )) ∘ t ( g ( x , 1 )) ∘ t ( g ( x , 2 )) ∘ ⋯ a ( 1 , 1 ) … a ( x , y ) a(1, 1) \ldots a(x, y) a ( 1 , 1 ) … a ( x , y )
其实这里 t ( x ) t(x) t ( x )
下面给出单点加、查询子矩阵和的代码.
实现
单点加
void add (int x, int y, int v) for (int i = x; i <= n; i += lowbit (i)) {
for (int j = y; j <= m; j += lowbit (j)) {
c[i][j] += v;
}
}
}
查询子矩阵和
int sum (int x, int y) int res = 0 ;
for (int i = x; i > 0 ; i -= lowbit (i)) {
for (int j = y; j > 0 ; j -= lowbit (j)) {
res += c[i][j];
}
}
return res;
}
int ask (int x1, int y1, int x2, int y2) return sum (x2, y2) - sum (x2, y1 - 1 ) - sum (x1 - 1 , y2) + sum (x1 - 1 , y1 - 1 );
}
子矩阵加,求子矩阵和
前置知识:前缀和 & 差分 和本页面 区间加区间和 一节.
和一维树状数组的「区间加区间和」问题类似,考虑维护差分数组.
二维数组上的差分数组是这样的:
d ( i , j ) = a ( i , j ) − a ( i − 1 , j ) − a ( i , j − 1 ) + a ( i − 1 , j − 1 ) . d(i, j) = a(i, j) - a(i - 1, j) - a(i, j - 1) + a(i - 1, j - 1). d ( i , j ) = a ( i , j ) − a ( i − 1 , j ) − a ( i , j − 1 ) + a ( i − 1 , j − 1 ) .
为什么这么定义?
这是因为,理想规定状态下,在差分矩阵上做二维前缀和应该得到原矩阵,因为这是一对逆运算.
二维前缀和的公式是这样的:
s ( i , j ) = s ( i − 1 , j ) + s ( i , j − 1 ) − s ( i − 1 , j − 1 ) + a ( i , j ) s(i, j) = s(i - 1, j) + s(i, j - 1) - s(i - 1, j - 1) + a(i, j) s ( i , j ) = s ( i − 1 , j ) + s ( i , j − 1 ) − s ( i − 1 , j − 1 ) + a ( i , j )
所以,设 a a a d d d
a ( i , j ) = a ( i − 1 , j ) + a ( i , j − 1 ) − a ( i − 1 , j − 1 ) + d ( i , j ) a(i, j) = a(i - 1, j) + a(i, j - 1) - a(i - 1, j - 1) + d(i, j) a ( i , j ) = a ( i − 1 , j ) + a ( i , j − 1 ) − a ( i − 1 , j − 1 ) + d ( i , j )
移项就得到二维差分的公式了.
d ( i , j ) = a ( i , j ) − a ( i − 1 , j ) − a ( i , j − 1 ) + a ( i − 1 , j − 1 ) d(i, j) = a(i, j) - a(i - 1, j) - a(i, j - 1) + a(i - 1, j - 1) d ( i , j ) = a ( i , j ) − a ( i − 1 , j ) − a ( i , j − 1 ) + a ( i − 1 , j − 1 )
这样以来,对左上角 ( x 1 , y 1 ) (x_1, y_1) ( x 1 , y 1 ) ( x 2 , y 2 ) (x_2, y_2) ( x 2 , y 2 ) v v v d ( x 1 , y 1 ) d(x_1, y_1) d ( x 1 , y 1 ) d ( x 2 + 1 , y 2 + 1 ) d(x_2 + 1, y_2 + 1) d ( x 2 + 1 , y 2 + 1 ) v v v d ( x 2 + 1 , y 1 ) d(x_2 + 1, y_1) d ( x 2 + 1 , y 1 ) d ( x 1 , y 2 + 1 ) d(x_1, y_2 + 1) d ( x 1 , y 2 + 1 ) − v -v − v
至于原因,把这四个 d d d
举个例子吧,初始差分数组为 0 0 0 a ( 2 , 2 ) … a ( 3 , 4 ) a(2, 2) \ldots a(3, 4) a ( 2 , 2 ) … a ( 3 , 4 ) v v v
( 0 0 0 0 0 0 v 0 0 − v 0 0 0 0 0 0 − v 0 0 v ) \begin{pmatrix}0&0&0&0&0\\0&v&0&0&-v\\0&0&0&0&0\\0&-v&0&0&v\end{pmatrix} 0 0 0 0 0 v 0 − v 0 0 0 0 0 0 0 0 0 − v 0 v (其中 a ( 2 , 2 ) … a ( 3 , 4 ) a(2, 2) \ldots a(3, 4) a ( 2 , 2 ) … a ( 3 , 4 ) 2 × 3 2 \times 3 2 × 3
因此,子矩阵加的做法是:转化为差分数组上的四个单点加操作.
现在考虑查询子矩阵和:
对于点 ( x , y ) (x, y) ( x , y )
∑ i = 1 x ∑ j = 1 y ∑ h = 1 i ∑ k = 1 j d ( h , k ) \sum_{i = 1}^x\sum_{j = 1}^y\sum_{h = 1}^i\sum_{k = 1}^j d(h, k) i = 1 ∑ x j = 1 ∑ y h = 1 ∑ i k = 1 ∑ j d ( h , k ) 原因就是差分的前缀和的前缀和就是原本的前缀和.
和一维树状数组的「区间加区间和」问题类似,统计 d ( h , k ) d(h, k) d ( h , k ) ( x − h + 1 ) × ( y − k + 1 ) (x - h + 1) \times (y - k + 1) ( x − h + 1 ) × ( y − k + 1 )
然后接着推导:
∑ i = 1 x ∑ j = 1 y ∑ h = 1 i ∑ k = 1 j d ( h , k ) = ∑ i = 1 x ∑ j = 1 y d ( i , j ) × ( x − i + 1 ) × ( y − j + 1 ) = ∑ i = 1 x ∑ j = 1 y d ( i , j ) × ( x y + x + y + 1 ) − d ( i , j ) × i × ( y + 1 ) − d ( i , j ) × j × ( x + 1 ) + d ( i , j ) × i × j \begin{aligned}
&\sum_{i = 1}^x\sum_{j = 1}^y\sum_{h = 1}^i\sum_{k = 1}^j d(h, k)
\\=&\sum_{i = 1}^x\sum_{j = 1}^y d(i, j) \times (x - i + 1) \times (y - j + 1)
\\=&\sum_{i = 1}^x\sum_{j = 1}^y d(i, j) \times (xy + x + y + 1) - d(i, j) \times i \times (y + 1) - d(i, j) \times j \times (x + 1) + d(i, j) \times i \times j
\end{aligned} = = i = 1 ∑ x j = 1 ∑ y h = 1 ∑ i k = 1 ∑ j d ( h , k ) i = 1 ∑ x j = 1 ∑ y d ( i , j ) × ( x − i + 1 ) × ( y − j + 1 ) i = 1 ∑ x j = 1 ∑ y d ( i , j ) × ( x y + x + y + 1 ) − d ( i , j ) × i × ( y + 1 ) − d ( i , j ) × j × ( x + 1 ) + d ( i , j ) × i × j 所以我们需维护四个树状数组,分别维护 d ( i , j ) d(i, j) d ( i , j ) d ( i , j ) × i d(i, j) \times i d ( i , j ) × i d ( i , j ) × j d(i, j) \times j d ( i , j ) × j d ( i , j ) × i × j d(i, j) \times i \times j d ( i , j ) × i × j
当然了,和一维同理,如果只需要子矩阵加求单点值,维护一个差分数组然后询问前缀和就足够了.
下面给出代码:
实现
using ll = long long ;
ll t1[N][N], t2[N][N], t3[N][N], t4[N][N];
void add (ll x, ll y, ll z) for (int X = x; X <= n; X += lowbit (X))
for (int Y = y; Y <= m; Y += lowbit (Y)) {
t1[X][Y] += z;
t2[X][Y] += z * x;
t3[X][Y] += z * y;
t4[X][Y] += z * x * y;
}
}
void range_add (ll xa, ll ya, ll xb, ll yb,
ll z) add (xa, ya, z);
add (xa, yb + 1 , -z);
add (xb + 1 , ya, -z);
add (xb + 1 , yb + 1 , z);
}
ll ask (ll x, ll y) {
ll res = 0 ;
for (int i = x; i; i -= lowbit (i))
for (int j = y; j; j -= lowbit (j))
res += (x + 1 ) * (y + 1 ) * t1[i][j] - (y + 1 ) * t2[i][j] -
(x + 1 ) * t3[i][j] + t4[i][j];
return res;
}
ll range_ask (ll xa, ll ya, ll xb, ll yb) {
return ask (xb, yb) - ask (xb, ya - 1 ) - ask (xa - 1 , yb) + ask (xa - 1 , ya - 1 );
}
权值树状数组及应用
我们知道,普通树状数组直接在原序列的基础上构建,c 6 c_6 c 6 a [ 5 … 6 ] a[5 \ldots 6] a [ 5 … 6 ]
然而事实上,我们还可以在原序列的权值数组上构建树状数组,这就是权值树状数组.
什么是权值数组?
一个序列 a a a b b b b [ x ] b[x] b [ x ] x x x a a a
例如:a = ( 1 , 3 , 4 , 3 , 4 ) a = (1, 3, 4, 3, 4) a = ( 1 , 3 , 4 , 3 , 4 ) b = ( 1 , 0 , 2 , 2 ) b = (1, 0, 2, 2) b = ( 1 , 0 , 2 , 2 )
很明显,b b b a a a
若原数列值域过大,且重要的不是具体值而是值与值之间的相对大小关系,常 离散化 原数组后再建立权值数组.
另外,权值数组是原数组无序性的一种表示:它重点描述数组的元素内容,忽略了数组的顺序,若两数组只是顺序不同,所含内容一致,则它们的权值数组相同.
因此,对于给定数组的顺序不影响答案的问题,在权值数组的基础上思考一般更直观,比如 [NOIP2021] 数列 .
运用权值树状数组,我们可以解决一些经典问题.
单点修改,查询全局第 k k k
在此处只讨论第 k k k k k k k k k
该问题可离散化,如果原序列 a a a b b b a a a
对于单点修改,只需将对原数列的单点修改转化为对权值数组的单点修改即可.具体来说,原数组 a [ x ] a[x] a [ x ] y y y z z z b b b b [ y ] b[y] b [ y ] 1 1 1 b [ z ] b[z] b [ z ] 1 1 1
对于查询第 k k k x x x [ 1 , x ] [1, x] [ 1 , x ] x 0 x_0 x 0 [ 1 , x 0 ] [1, x_0] [ 1 , x 0 ] < k < k < k [ 1 , x 0 + 1 ] [1, x_0 + 1] [ 1 , x 0 + 1 ] ≥ k \ge k ≥ k k k k x 0 + 1 x_0 + 1 x 0 + 1 [ 1 , 0 ] [1, 0] [ 1 , 0 ] 0 0 0
这样做时间复杂度是 Θ ( log 2 n ) \Theta(\log^2n) Θ ( log 2 n )
考虑用倍增替代二分.
设 x = 0 x = 0 x = 0 s u m = 0 \mathrm{sum} = 0 sum = 0 i i i log 2 n \log_2n log 2 n 0 0 0
查询权值数组中 [ x + 1 … x + 2 i ] [x + 1 \ldots x + 2^i] [ x + 1 … x + 2 i ] t t t
如果 s u m + t < k \mathrm{sum} + t < k sum + t < k x ← x + 2 i x \gets x + 2^i x ← x + 2 i s u m ← s u m + t \mathrm{sum} \gets \mathrm{sum} + t sum ← sum + t
这样得到的 x x x [ 1 … x ] [1 \ldots x] [ 1 … x ] < k < k < k x + 1 x + 1 x + 1
看起来这种方法时间效率没有任何改善,但事实上,查询 [ x + 1 … x + 2 i ] [x + 1 \ldots x + 2^i] [ x + 1 … x + 2 i ] c [ x + 2 i ] c[x + 2^i] c [ x + 2 i ]
原因很简单,考虑 lowbit ( x + 2 i ) \operatorname{lowbit}(x + 2^i) lowbit ( x + 2 i ) 2 i 2^i 2 i x x x 2 j 2^j 2 j j > i j > i j > i c [ x + 2 i ] c[x + 2^i] c [ x + 2 i ] [ x + 1 … x + 2 i ] [x + 1 \ldots x + 2^i] [ x + 1 … x + 2 i ]
如此一来,时间复杂度降低为 Θ ( log n ) \Theta(\log n) Θ ( log n )
实现
C++
int kth (int k) int sum = 0 , x = 0 ;
for (int i = log2 (n); ~i; --i) {
x += 1 << i;
if (x > n || sum + t[x] >= k)
x -= 1 << i;
else
sum += t[x];
}
return x + 1 ;
}
Python
def kth (k ):
sum = 0
x = 0
i = int (log2(n))
while ~i:
x = x + (1 << i)
if x > n or sum + t[x] >= k:
x = x - (1 << i)
else :
sum = sum + t[x]
i = i - 1
return x + 1
全局逆序对(全局二维偏序)
相关阅读和参考实现:逆序对
全局逆序对也可以用权值树状数组巧妙解决.问题是这样的:给定长度为 n n n a a a a a a i < j i < j i < j a [ i ] > a [ j ] a[i] > a[j] a [ i ] > a [ j ] ( i , j ) (i, j) ( i , j )
该问题可离散化,如果原序列 a a a b b b
我们考虑从 n n n 1 1 1 i i i j > i j > i j > i a [ j ] < a [ i ] a[j] < a[i] a [ j ] < a [ i ]
事实上,我们只需要这样做(设当前 a [ i ] = x a[i] = x a [ i ] = x
查询 b [ 1 … x − 1 ] b[1 \ldots x - 1] b [ 1 … x − 1 ] a [ i ] a[i] a [ i ]
b [ x ] b[x] b [ x ] 1 1 1
原因十分自然:出现在 b [ 1 … x − 1 ] b[1 \ldots x-1] b [ 1 … x − 1 ] x = a [ i ] x = a[i] x = a [ i ] i i i j j j i i i
用例子说明,a = ( 4 , 3 , 1 , 2 , 1 ) a = (4, 3, 1, 2, 1) a = ( 4 , 3 , 1 , 2 , 1 )
i i i 5 → 1 5 \to 1 5 → 1
a [ 5 ] = 1 a[5] = 1 a [ 5 ] = 1 b [ 1 … 0 ] b[1 \ldots 0] b [ 1 … 0 ] 0 0 0 b [ 1 ] b[1] b [ 1 ] 1 1 1 b = ( 1 , 0 , 0 , 0 ) b = (1, 0, 0, 0) b = ( 1 , 0 , 0 , 0 ) a [ 4 ] = 2 a[4] = 2 a [ 4 ] = 2 b [ 1 … 1 ] b[1 \ldots 1] b [ 1 … 1 ] 1 1 1 b [ 2 ] b[2] b [ 2 ] 1 1 1 b = ( 1 , 1 , 0 , 0 ) b = (1, 1, 0, 0) b = ( 1 , 1 , 0 , 0 ) a [ 3 ] = 1 a[3] = 1 a [ 3 ] = 1 b [ 1 … 0 ] b[1 \ldots 0] b [ 1 … 0 ] 0 0 0 b [ 1 ] b[1] b [ 1 ] 1 1 1 b = ( 2 , 1 , 0 , 0 ) b = (2, 1, 0, 0) b = ( 2 , 1 , 0 , 0 ) a [ 2 ] = 3 a[2] = 3 a [ 2 ] = 3 b [ 1 … 2 ] b[1 \ldots 2] b [ 1 … 2 ] 3 3 3 b [ 3 ] b[3] b [ 3 ] 1 1 1 b = ( 2 , 1 , 1 , 0 ) b = (2, 1, 1, 0) b = ( 2 , 1 , 1 , 0 ) a [ 1 ] = 4 a[1] = 4 a [ 1 ] = 4 b [ 1 … 3 ] b[1 \ldots 3] b [ 1 … 3 ] 4 4 4 b [ 4 ] b[4] b [ 4 ] 1 1 1 b = ( 2 , 1 , 1 , 1 ) b = (2, 1, 1, 1) b = ( 2 , 1 , 1 , 1 )
所以最终答案为 0 + 1 + 0 + 3 + 4 = 8 0 + 1 + 0 + 3 + 4 = 8 0 + 1 + 0 + 3 + 4 = 8
注意到,遍历 i i i b [ 1 … x − 1 ] b[1 \ldots x - 1] b [ 1 … x − 1 ] b [ x ] b[x] b [ x ] b [ x ] b[x] b [ x ] b [ 1 … x − 1 ] b[1 \ldots x - 1] b [ 1 … x − 1 ]
对 b [ x ] b[x] b [ x ] b [ 1 … x − 1 ] b[1 \ldots x - 1] b [ 1 … x − 1 ]
颠倒后,实质是在查询 i ≤ j i \le j i ≤ j a [ i ] > a [ j ] a[i] > a[j] a [ i ] > a [ j ] i = j i = j i = j a [ i ] > a [ j ] a[i] > a[j] a [ i ] > a [ j ] i ≤ j i \le j i ≤ j i < j i < j i < j
如果查询非严格逆序对(i < j i < j i < j a [ i ] ≥ a [ j ] a[i] \ge a[j] a [ i ] ≥ a [ j ] b [ 1 … x ] b[1 \ldots x] b [ 1 … x ]
对 b [ x ] b[x] b [ x ] 影响 对 b [ 1 … x ] b[1 \ldots x] b [ 1 … x ]
颠倒后,实质是在查询 i ≤ j i \le j i ≤ j a [ i ] ≥ a [ j ] a[i] \ge a[j] a [ i ] ≥ a [ j ] i = j i = j i = j a [ i ] ≥ a [ j ] a[i] \ge a[j] a [ i ] ≥ a [ j ] i ≤ j i \le j i ≤ j 不相当于 i < j i < j i < j 不等价 .
如果查询 i ≤ j i \le j i ≤ j a [ i ] ≥ a [ j ] a[i] \ge a[j] a [ i ] ≥ a [ j ]
另外,对于原逆序对问题,还有一种做法是正着枚举 j j j i < j i < j i < j a [ i ] > a [ j ] a[i] > a[j] a [ i ] > a [ j ] x = a [ j ] x = a[j] x = a [ j ]
查询 b [ x + 1 … V ] b[x + 1 \ldots V] b [ x + 1 … V ] V V V b b b a a a
将 b [ x ] b[x] b [ x ] 1 1 1
原因:出现在 b [ x + 1 … V ] b[x + 1 \ldots V] b [ x + 1 … V ] x = a [ j ] x = a[j] x = a [ j ] j j j i i i j j j
此外,逆序对的计数还可以通过 归并排序 解决.这一方法可以避免离散化.时间复杂度同样为 O ( n log n ) O(n\log n) O ( n log n ) 逆序对 章节.
树状数组维护不可差分信息
比如维护区间最值等.
注意,这种方法虽然码量小,但单点修改和区间查询的时间复杂度均为 Θ ( log 2 n ) \Theta(\log^2n) Θ ( log 2 n ) Θ ( log n ) \Theta(\log n) Θ ( log n )
区间查询
我们还是基于之前的思路,从 r r r lowbit \operatorname{lowbit} lowbit l l l
因此,如果我们跳到了 c [ x ] c[x] c [ x ] x − lowbit ( x ) x - \operatorname{lowbit}(x) x − lowbit ( x ) l l l
如果小于 l l l a [ x ] \boldsymbol{a[x]} a [ x ] c [ x − 1 ] c[x - 1] c [ x − 1 ]
如果大于等于 l l l c [ x ] c[x] c [ x ] c [ x − lowbit ( x ) ] c[x - \operatorname{lowbit}(x)] c [ x − lowbit ( x )]
下面以查询区间最大值为例,给出代码:
实现
int getmax (int l, int r) int ans = 0 ;
while (r >= l) {
ans = max (ans, a[r]);
--r;
for (; r - lowbit (r) >= l; r -= lowbit (r)) {
ans = max (ans, C[r]);
}
}
return ans;
}
可以证明,上述算法的时间复杂度是 Θ ( log 2 n ) \Theta(\log^2n) Θ ( log 2 n )
时间复杂度证明
考虑 r r r l l l r r r 1 1 1 l l l 0 0 0 r ≥ l r \ge l r ≥ l
如果 r r r 1 1 1 r − lowbit ( r ) ≥ l r - \operatorname{lowbit}(r) \ge l r − lowbit ( r ) ≥ l r r r 1 1 1 0 0 0
如果 r r r 1 1 1 r r r 1 1 1 r ← r − lowbit ( r ) r \gets r - \operatorname{lowbit}(r) r ← r − lowbit ( r ) r ← r − 1 r \gets r - 1 r ← r − 1 r r r 1 1 1 0 0 0
因此,r r r log n \log n log n r r r l l l Θ ( log 2 n ) \Theta(\log^2n) Θ ( log 2 n )
单点更新
注
请先理解树状数组树形态的以下两条性质,再学习本节.
设 u = s × 2 k + 1 + 2 k u = s \times 2^{k + 1} + 2^k u = s × 2 k + 1 + 2 k k = log 2 lowbit ( u ) k = \log_2\operatorname{lowbit}(u) k = log 2 lowbit ( u ) u − 2 t ( 0 ≤ t < k ) u - 2^t(0 \le t < k) u − 2 t ( 0 ≤ t < k )
u u u c c c [ l ( u ) , u − 1 ] [l(u), u - 1] [ l ( u ) , u − 1 ]
关于这两条性质的含义及证明,都可以在本页面的 树状数组与其树形态的性质 一节找到.
更新 a [ x ] a[x] a [ x ] y y y x x x c [ y ] c[y] c [ y ]
对于最值(以最大值为例),一种常见的错误想法是,如果 a [ x ] a[x] a [ x ] p p p c [ y ] c[y] c [ y ] max ( c [ y ] , p ) \max(c[y], p) max ( c [ y ] , p ) ( 1 , 2 , 3 , 4 , 5 ) (1, 2, 3, 4, 5) ( 1 , 2 , 3 , 4 , 5 ) 5 5 5 4 4 4 4 4 4 5 5 5 c [ y ] c[y] c [ y ] p p p 3 3 3 4 4 4
事实上,对于不可差分信息,不存在通过 p p p c [ y ] c[y] c [ y ] c [ y ] c[y] c [ y ]
换句话说,对每个受影响的 c [ y ] c[y] c [ y ]
考虑 c [ y ] c[y] c [ y ] [ l ( y ) , y − 1 ] [l(y), y - 1] [ l ( y ) , y − 1 ] a [ y ] a[y] a [ y ] [ l ( y ) , y ] [l(y), y] [ l ( y ) , y ] c [ y ] c[y] c [ y ] log n \log n log n c c c
实现
void update (int x, int v) for (int i = x; i <= n; i += lowbit (i)) {
C[i] = a[i];
for (int j = 1 ; j < lowbit (i); j *= 2 ) {
C[i] = max (C[i], C[i - j]);
}
}
}
容易看出上述算法时间复杂度为 Θ ( log 2 n ) \Theta(\log^2n) Θ ( log 2 n )
建树
可以考虑拆成 n n n Θ ( n log 2 n ) \Theta(n\log^2n) Θ ( n log 2 n )
也有 Θ ( n ) \Theta(n) Θ ( n ) Θ ( n ) \Theta(n) Θ ( n )
Tricks
Θ ( n ) \Theta(n) Θ ( n ) 以维护区间和为例.
方法一:
每一个节点的值是由所有与自己直接相连的儿子的值求和得到的.因此可以倒着考虑贡献,即每次确定完儿子的值后,用自己的值更新自己的直接父亲.
实现
C++
void init () for (int i = 1 ; i <= n; ++i) {
t[i] += a[i];
int j = i + lowbit (i);
if (j <= n) t[j] += t[i];
}
}
Python
def init ():
for i in range (1 , n + 1 ):
t[i] = t[i] + a[i]
j = i + lowbit(i)
if j <= n:
t[j] = t[j] + t[i]
方法二:
前面讲到 c [ i ] c[i] c [ i ] [ i − lowbit ( i ) + 1 , i ] [i-\operatorname{lowbit}(i)+1, i] [ i − lowbit ( i ) + 1 , i ] s u m \mathrm{sum} sum c c c
实现
C++
void init () for (int i = 1 ; i <= n; ++i) {
t[i] = sum[i] - sum[i - lowbit (i)];
}
}
Python
def init ():
for i in range (1 , n + 1 ):
t[i] = sum [i] - sum [i - lowbit(i)]
时间戳优化
对付多组数据很常见的技巧.若每次输入新数据都暴力清空树状数组,就可能会造成超时.因此使用 t a g \mathrm{tag} tag t a g \mathrm{tag} tag 0 0 0
实现
C++
int tag[MAXN], t[MAXN], Tag;
void reset () void add (int k, int v) while (k <= n) {
if (tag[k] != Tag) t[k] = 0 ;
t[k] += v, tag[k] = Tag;
k += lowbit (k);
}
}
int getsum (int k) int ret = 0 ;
while (k) {
if (tag[k] == Tag) ret += t[k];
k -= lowbit (k);
}
return ret;
}
Python
tag = [0 ] * MAXN
t = [0 ] * MAXN
Tag = 0
def reset ():
Tag = Tag + 1
def add (k, v ):
while k <= n:
if tag[k] != Tag:
t[k] = 0
t[k] = t[k] + v
tag[k] = Tag
k = k + lowbit(k)
def getsum (k ):
ret = 0
while k:
if tag[k] == Tag:
ret = ret + t[k]
k = k - lowbit(k)
return ret
例题