本部分内容转载并修改自 时间复杂度 - 势能分析浅谈 ,已取得原作者授权同意.
定义
阿克曼函数
这里,先给出 α ( n ) \alpha(n) α ( n ) A k ( j ) A_k(j) A k ( j )
定义 A k ( j ) A_k(j) A k ( j )
A k ( j ) = { j + 1 k = 0 A k − 1 ( j + 1 ) ( j ) k ≥ 1 A_k(j)=\left\{
\begin{aligned}
&j+1& &k=0&\\
&A_{k-1}^{(j+1)}(j)& &k\geq1&
\end{aligned}
\right. A k ( j ) = { j + 1 A k − 1 ( j + 1 ) ( j ) k = 0 k ≥ 1 即阿克曼函数.
这里,f i ( x ) f^i(x) f i ( x ) f f f x x x i i i f 0 ( x ) = x f^0(x)=x f 0 ( x ) = x f i ( x ) = f ( f i − 1 ( x ) ) f^i(x)=f(f^{i-1}(x)) f i ( x ) = f ( f i − 1 ( x ))
再定义 α ( n ) \alpha(n) α ( n ) A α ( n ) ( 1 ) ≥ n A_{\alpha(n)}(1)\geq n A α ( n ) ( 1 ) ≥ n A α ( n ) ( α ( n ) ) ≥ n A_{\alpha(n)}(\alpha(n))\geq n A α ( n ) ( α ( n )) ≥ n
基础定义
每个节点都有一个 rank.这里的 rank 不是节点个数,而是深度.节点的初始 rank 为 0,在合并的时候,如果两个节点的 rank 不同,则将 rank 小的节点合并到 rank 大的节点上,并且不更新大节点的 rank 值.否则,随机将某个节点合并到另外一个节点上,将根节点的 rank 值 +1.这里根节点的 rank 给出了该树的高度.记 x 的 rank 为 r n k ( x ) rnk(x) r nk ( x ) f a ( x ) fa(x) f a ( x ) r n k ( x ) + 1 ≤ r n k ( f a ( x ) ) rnk(x)+1\leq rnk(fa(x)) r nk ( x ) + 1 ≤ r nk ( f a ( x ))
为了定义势函数,需要预先定义一个辅助函数 l e v e l ( x ) level(x) l e v e l ( x ) l e v e l ( x ) = max ( k : r n k ( f a ( x ) ) ≥ A k ( r n k ( x ) ) ) level(x)=\max(k:rnk(fa(x))\geq A_k(rnk(x))) l e v e l ( x ) = max ( k : r nk ( f a ( x )) ≥ A k ( r nk ( x ))) r n k ( x ) ≥ 1 rnk(x)\geq1 r nk ( x ) ≥ 1 i t e r ( x ) = max ( i : r n k ( f a ( x ) ) ≥ A l e v e l ( x ) i ( r n k ( x ) ) iter(x)=\max(i:rnk(fa(x))\geq A_{level(x)}^i(rnk(x)) i t er ( x ) = max ( i : r nk ( f a ( x )) ≥ A l e v e l ( x ) i ( r nk ( x )) x x x r n k ( x ) > 0 rnk(x)>0 r nk ( x ) > 0 x x x
上面那些定义可能让你有点头晕.再理一下,对于一个 x x x f a ( x ) fa(x) f a ( x ) r n k ( x ) > 0 rnk(x)>0 r nk ( x ) > 0 i , k i,k i , k r n k ( f a ( x ) ) ≥ A k i ( r n k ( x ) ) rnk(fa(x))\geq A_k^i(rnk(x)) r nk ( f a ( x )) ≥ A k i ( r nk ( x )) l e v e l ( x ) = max ( k ) level(x)=\max(k) l e v e l ( x ) = max ( k ) i t e r ( x ) = max ( i ) iter(x)=\max(i) i t er ( x ) = max ( i ) l e v e l level l e v e l A A A i t e r iter i t er
对于这两个函数,l e v e l ( x ) level(x) l e v e l ( x ) l e v e l ( x ) level(x) l e v e l ( x ) i t e r ( x ) iter(x) i t er ( x )
0 ≤ l e v e l ( x ) < α ( n ) 0\leq level(x)<\alpha(n) 0 ≤ l e v e l ( x ) < α ( n ) 1 ≤ i t e r ( x ) ≤ r n k ( x ) 1\leq iter(x)\leq rnk(x) 1 ≤ i t er ( x ) ≤ r nk ( x ) 考虑 l e v e l ( x ) level(x) l e v e l ( x ) i t e r ( x ) iter(x) i t er ( x ) A k j A_k^j A k j
定义势能函数 Φ ( S ) = ∑ x ∈ S Φ ( x ) \Phi(S)=\sum\limits_{x\in S}\Phi(x) Φ ( S ) = x ∈ S ∑ Φ ( x ) S S S x x x Φ ( x ) \Phi(x) Φ ( x )
Φ ( x ) = { α ( n ) × r n k ( x ) r n k ( x ) = 0 或 x 为某棵树的根节点 ( α ( n ) − l e v e l ( x ) ) × r n k ( x ) − i t e r ( x ) otherwise \Phi(x)=
\begin{cases}
\alpha(n)\times \mathit{rnk}(x)& \mathit{rnk}(x)=0\ \text{或}\ x\ \text{为某棵树的根节点}\\
(\alpha(n)-\mathit{level}(x))\times \mathit{rnk}(x)-iter(x)& \text{otherwise}
\end{cases} Φ ( x ) = { α ( n ) × rnk ( x ) ( α ( n ) − level ( x )) × rnk ( x ) − i t er ( x ) rnk ( x ) = 0 或 x 为某棵树的根节点 otherwise 然后就是通过操作引起的势能变化来证明摊还时间复杂度为 Θ ( α ( n ) ) \Theta(\alpha(n)) Θ ( α ( n )) u n i o n ( x , y ) union(x,y) u ni o n ( x , y ) x x x y y y f i n d ( x ) find(x) f in d ( x ) f i n d ( y ) find(y) f in d ( y )
可以发现,势能总是个非负数.另,在开始的时候,并查集的势能为 0 0 0
证明
union(x,y) 操作
其花费的时间为 Θ ( 1 ) \Theta(1) Θ ( 1 )
这里,我们假设 r n k ( x ) ≤ r n k ( y ) rnk(x)\leq rnk(y) r nk ( x ) ≤ r nk ( y ) x x x y y y x x x y y y y y y y y y c c c 1 1 1
设操作前 c c c Φ ( c ) \Phi(c) Φ ( c ) Φ ( c ′ ) \Phi(c') Φ ( c ′ ) c c c r n k ( c ) > 0 rnk(c)>0 r nk ( c ) > 0
i t e r ( c ) iter(c) i t er ( c ) l e v e l ( c ) level(c) l e v e l ( c ) Φ ( c ) = Φ ( c ′ ) \Phi(c)=\Phi(c') Φ ( c ) = Φ ( c ′ ) i t e r ( c ) iter(c) i t er ( c ) l e v e l ( c ) level(c) l e v e l ( c ) i t e r ( c ) iter(c) i t er ( c ) Φ ( c ′ ) ≤ Φ ( c ) − 1 \Phi(c')\leq \Phi(c)-1 Φ ( c ′ ) ≤ Φ ( c ) − 1 l e v e l ( c ) level(c) l e v e l ( c ) i t e r ( c ) iter(c) i t er ( c ) 0 < i t e r ( c ) ≤ r n k ( c ) 0<iter(c)\leq rnk(c) 0 < i t er ( c ) ≤ r nk ( c ) i t e r ( c ) iter(c) i t er ( c ) r n k ( c ) − 1 rnk(c)-1 r nk ( c ) − 1 l e v e l ( c ) level(c) l e v e l ( c ) 1 1 1 Φ ( c ) = ( α ( n ) − l e v e l ( c ) ) × r n k ( c ) − i t e r ( c ) \Phi(c)=(\alpha(n)-level(c))\times rnk(c)-iter(c) Φ ( c ) = ( α ( n ) − l e v e l ( c )) × r nk ( c ) − i t er ( c ) Φ ( c ′ ) ≤ Φ ( c ) − 1 \Phi(c')\leq\Phi(c)-1 Φ ( c ′ ) ≤ Φ ( c ) − 1 其他情况.由于 r n k ( c ) rnk(c) r nk ( c ) r n k ( f a ( c ) ) rnk(fa(c)) r nk ( f a ( c ))
所以,势能增加的节点仅可能是 x x x y y y x x x r n k ( x ) = 0 rnk(x)=0 r nk ( x ) = 0 Φ ( x ) = Φ ( x ′ ) = 0 \Phi(x)=\Phi(x')=0 Φ ( x ) = Φ ( x ′ ) = 0 α ( x ) × r n k ( x ) ≥ ( α ( n ) − l e v e l ( x ) ) × r n k ( x ) − i t e r ( x ) \alpha(x)\times rnk(x)\geq(\alpha(n)-level(x))\times rnk(x)-iter(x) α ( x ) × r nk ( x ) ≥ ( α ( n ) − l e v e l ( x )) × r nk ( x ) − i t er ( x ) Φ ( x ′ ) ≤ Φ ( x ) \Phi(x')\leq \Phi(x) Φ ( x ′ ) ≤ Φ ( x )
因此,唯一势能可能增加的点就是 y y y y y y α ( n ) \alpha(n) α ( n ) u n i o n union u ni o n Θ ( α ( n ) ) \Theta(\alpha(n)) Θ ( α ( n ))
find(a) 操作
如果查找路径包含 Θ ( s ) \Theta(s) Θ ( s ) Θ ( s ) \Theta(s) Θ ( s ) s − α ( n ) s-\alpha(n) s − α ( n ) 1 1 1 f i n d ( a ) find(a) f in d ( a ) Θ ( α ( n ) ) \Theta(\alpha(n)) Θ ( α ( n )) a a a x x x
首先证明没有节点的势能增加.很显然,我们在上面证明过所有非根节点的势能不增,而根节点的 r n k rnk r nk
接下来证明至少有 s − α ( n ) s-\alpha(n) s − α ( n ) 1 1 1 l e v e l ( x ) level(x) l e v e l ( x ) i t e r ( x ) iter(x) i t er ( x ) 1 1 1 s − α ( n ) s-\alpha(n) s − α ( n ) l e v e l ( x ) level(x) l e v e l ( x ) i t e r ( x ) iter(x) i t er ( x )
回忆一下非根节点势能的定义,Φ ( x ) = ( α ( n ) − l e v e l ( x ) ) × r n k ( x ) − i t e r ( x ) \Phi(x)=(\alpha(n)-level(x))\times rnk(x)-iter(x) Φ ( x ) = ( α ( n ) − l e v e l ( x )) × r nk ( x ) − i t er ( x ) l e v e l ( x ) level(x) l e v e l ( x ) i t e r ( x ) iter(x) i t er ( x ) r n k ( f a ( x ) ) ≥ A l e v e l ( x ) i t e r ( x ) ( r n k ( x ) ) rnk(fa(x))\geq A_{level(x)}^{iter(x)}(rnk(x)) r nk ( f a ( x )) ≥ A l e v e l ( x ) i t er ( x ) ( r nk ( x ))
所以,如果 r o o t x root_x r oo t x x x x r n k ( r o o t x ) ≥ A l e v e l ( x ) i t e r ( x ) + 1 ( r n k ( x ) ) rnk(root_x)\geq A_{level(x)}^{iter(x)+1}(rnk(x)) r nk ( r oo t x ) ≥ A l e v e l ( x ) i t er ( x ) + 1 ( r nk ( x )) A k i A_k^i A k i A l e v e l ( x ) i t e r ( x ) + 1 ( r n k ( x ) ) = A l e v e l ( x ) ( A l e v e l ( x ) i t e r ( x ) ( r n k ( x ) ) ) A_{level(x)}^{iter(x)+1}(rnk(x))=A_{level(x)}(A_{level(x)}^{iter(x)}(rnk(x))) A l e v e l ( x ) i t er ( x ) + 1 ( r nk ( x )) = A l e v e l ( x ) ( A l e v e l ( x ) i t er ( x ) ( r nk ( x )))
注意,我们可能会用 k ( x ) k(x) k ( x ) l e v e l ( x ) level(x) l e v e l ( x ) i ( x ) i(x) i ( x ) i t e r ( x ) iter(x) i t er ( x ) r n k ( r o o t x ) ≥ A k ( x ) ( A k ( x ) i ( x ) ( x ) ) rnk(root_x)\geq A_{k(x)}(A_{k(x)}^{i(x)}(x)) r nk ( r oo t x ) ≥ A k ( x ) ( A k ( x ) i ( x ) ( x ))
当你看到这的时候,可能会有一种「这啥玩意」的感觉.这意味着你可能需要多看几遍,或者跳过一些内容以后再看.
这里,我们需要一个外接的 A k ( x ) A_{k(x)} A k ( x ) y y y y y y x x x k ( y ) = k ( x ) k(y)=k(x) k ( y ) = k ( x ) x x x x x x y y y y y y x x x α ( n ) + 2 \alpha(n)+2 α ( n ) + 2 k k k x x x a a a r o o t a root_a r oo t a y y y
我们再强调一遍 f a ( x ) fa(x) f a ( x ) 之前 x x x 之后 x x x r o o t x root_x r oo t x y y y x x x r n k ( y ) ≥ r n k ( f a ( x ) ) rnk(y)\geq rnk(fa(x)) r nk ( y ) ≥ r nk ( f a ( x )) r n k ( f a ( x ) ) ≥ A k ( x ) i ( x ) ( r n k ( x ) ) rnk(fa(x))\geq A_{k(x)}^{i(x)}(rnk(x)) r nk ( f a ( x )) ≥ A k ( x ) i ( x ) ( r nk ( x )) k ( x ) = k ( y ) k(x)=k(y) k ( x ) = k ( y ) k k k r n k ( f a ( x ) ) ≥ A k i ( x ) ( r n k ( x ) ) rnk(fa(x))\geq A_k^{i(x)}(rnk(x)) r nk ( f a ( x )) ≥ A k i ( x ) ( r nk ( x )) A k A_k A k i t e r ( y ) iter(y) i t er ( y ) r n k ( f a ( y ) ) ≥ A k ( r n k ( y ) ) rnk(fa(y))\geq A_k(rnk(y)) r nk ( f a ( y )) ≥ A k ( r nk ( y ))
如果我们将不等式组合起来,神奇的事情就发生了.我们发现,r n k ( f a ( y ) ) ≥ A k i ( x ) + 1 ( r n k ( x ) ) rnk(fa(y))\geq A_k^{i(x)+1}(rnk(x)) r nk ( f a ( y )) ≥ A k i ( x ) + 1 ( r nk ( x )) r n k ( x ) rnk(x) r nk ( x ) r n k ( f a ( y ) ) rnk(fa(y)) r nk ( f a ( y )) A k A_k A k i ( x ) + 1 i(x)+1 i ( x ) + 1 r n k ( f a ( y ) ) rnk(fa(y)) r nk ( f a ( y ))
显然,有 r n k ( r o o t y ) ≥ r n k ( f a ( y ) ) rnk(root_y)\geq rnk(fa(y)) r nk ( r oo t y ) ≥ r nk ( f a ( y )) r n k ( x ) rnk(x) r nk ( x ) r n k ( r o o t x ) ≥ A k i ( x ) + 1 ( r n k ( x ) ) rnk(root_x)\geq A_k^{i(x)+1}(rnk(x)) r nk ( r oo t x ) ≥ A k i ( x ) + 1 ( r nk ( x )) i t e r ( x ) iter(x) i t er ( x ) r n k ( x ) rnk(x) r nk ( x ) l e v e l ( x ) level(x) l e v e l ( x )
所以,Φ ( x ) \Phi(x) Φ ( x ) x x x s − α ( n ) − 2 s-\alpha(n)-2 s − α ( n ) − 2 Φ ( S ) \Phi(S) Φ ( S ) s − α ( n ) − 2 s-\alpha(n)-2 s − α ( n ) − 2 Θ ( α ( n ) + 2 ) = Θ ( α ( n ) ) \Theta(\alpha(n)+2)=\Theta(\alpha(n)) Θ ( α ( n ) + 2 ) = Θ ( α ( n ))
为何并查集会被卡
这个问题也就是问,如果我们不按秩合并,会有哪些性质被破坏,导致并查集的时间复杂度不能保证为 Θ ( m α ( n ) ) \Theta(m\alpha(n)) Θ ( m α ( n ))
如果我们在合并的时候,r n k rnk r nk r n k rnk r nk r n k rnk r nk r n k rnk r nk r n k rnk r nk r n k ( f a ( x ) ) ≥ r n k ( x ) + 1 rnk(fa(x))\geq rnk(x)+1 r nk ( f a ( x )) ≥ r nk ( x ) + 1
显然,如果这样子的话,我们破坏的就是 u n i o n ( x , y ) union(x,y) u ni o n ( x , y ) α ( n ) \alpha(n) α ( n )
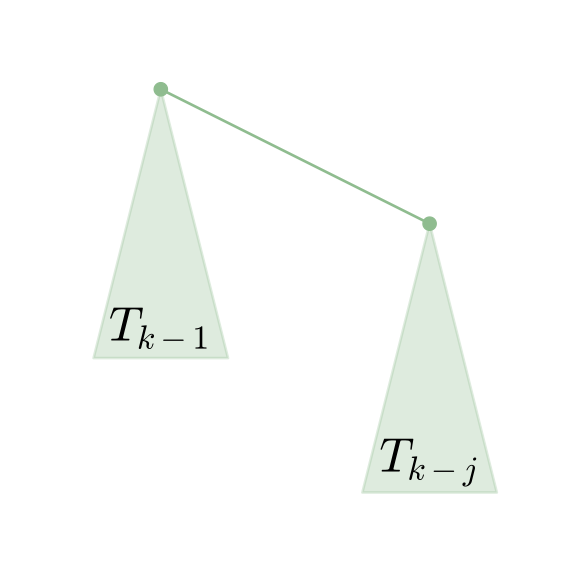
存在一个能使路径压缩并查集时间复杂度降至 Ω ( m log 1 + m n n ) \Omega(m\log_{1+\frac{m}{n}}n) Ω ( m log 1 + n m n )
二项树(实际上和一般的二项树不太一样),其中 j 是常数,T k T_k T k T k − 1 T_{k-1} T k − 1 T k − j T_{k-j} T k − j
二项树 边界条件,T 1 T_1 T 1 T j T_j T j
令 r n k ( T k ) = r k rnk(T_k)=r_k r nk ( T k ) = r k r k = ( k − 1 ) / j r_k=(k-1)/j r k = ( k − 1 ) / j j j j ( k − 1 ) / j + 1 (k-1)/j+1 ( k − 1 ) / j + 1 j = ⌊ m n ⌋ j=\lfloor\frac{m}{n}\rfloor j = ⌊ n m ⌋ i = ⌊ log j + 1 n 2 ⌋ i=\lfloor\log_{j+1}\frac{n}{2}\rfloor i = ⌊ log j + 1 2 n ⌋ k = i j k=ij k = ij
α ( n ) × ( ( i j − 1 ) / j + 1 ) = α ( n ) × ( ( ⌊ log ⌊ m n ⌋ + 1 n 2 ⌋ × ⌊ m n ⌋ − 1 ) / ⌊ m n ⌋ + 1 ) \alpha(n)\times((ij-1)/j+1)=\alpha(n)\times((\lfloor\log_{\lfloor\frac{m}{n}\rfloor+1}\frac{n}{2}\rfloor\times \lfloor\frac{m}{n}\rfloor-1)/\lfloor\frac{m}{n}\rfloor+1) α ( n ) × (( ij − 1 ) / j + 1 ) = α ( n ) × ((⌊ log ⌊ n m ⌋ + 1 2 n ⌋ × ⌊ n m ⌋ − 1 ) / ⌊ n m ⌋ + 1 ) 变换一下,去掉所有的取整符号,就可以得出,势能增加量 ≥ α ( n ) × ( log 1 + m n n − n m ) \geq \alpha(n)\times(\log_{1+\frac{m}{n}}n-\frac{n}{m}) ≥ α ( n ) × ( log 1 + n m n − m n ) Ω ( m log 1 + m n n − n ) = Ω ( m log 1 + m n n ) \Omega(m\log_{1+\frac{m}{n}}n-n)=\Omega(m\log_{1+\frac{m}{n}}n) Ω ( m log 1 + n m n − n ) = Ω ( m log 1 + n m n )
关于启发式合并
由于按秩合并比启发式合并难写,所以很多 dalao 会选择使用启发式合并来写并查集.具体来说,则是对每个根都维护一个 s i z e ( x ) size(x) s i z e ( x ) s i z e size s i z e
所以,启发式合并会不会被卡?
首先,可以从秩参与证明的性质来说明.如果 s i z e size s i z e r n k rnk r nk
每次合并,最多有一个节点的秩上升,而且最多上升 1.
总有 r n k ( f a ( x ) ) ≥ r n k ( x ) + 1 rnk(fa(x))\geq rnk(x)+1 r nk ( f a ( x )) ≥ r nk ( x ) + 1
节点的秩不减.
关于第二条和第三条,s i z siz s i z x x x y y y s i z ( y ) siz(y) s i z ( y ) s i z ( x ) siz(x) s i z ( x )
所以,可以考虑使用 log 2 s i z ( x ) \log_2 siz(x) log 2 s i z ( x ) r n k ( x ) rnk(x) r nk ( x )
关于第一条性质,由于节点的 s i z siz s i z log 2 s i z ( x ) \log_2 siz(x) log 2 s i z ( x )
所以说,如果不想写按秩合并,就写启发式合并好了,时间复杂度仍旧是 Θ ( m α ( n ) ) \Theta(m\alpha(n)) Θ ( m α ( n ))