引入
对于一类二维 DP 问题,如果它的价值函数 f ( i , x ) f(i,x) f ( i , x ) i i i x x x f ( i , ⋅ ) f(i,\cdot) f ( i , ⋅ ) i i i
Δ f ( i , x ) = f ( i , x + 1 ) − f ( i , x ) \Delta f(i,x) = f(i,x+1)-f(i,x) Δ f ( i , x ) = f ( i , x + 1 ) − f ( i , x ) 而非函数本身,往往能够起到优化转移的效果.这种优化 DP 的思想,就称为 Slope Trick.
「斜率」
因为大多数题目中涉及的函数都只在整点处取值,所以称它为差分和斜率没有本质区别,本文按照 Slope Trick 这个名词统一称呼它为斜率.
具体题目中,斜率的维护方式可能各不相同.如果斜率的取值范围较窄,维护斜率变化的点(即拐点)更为方便;而如果函数定义域较窄,维护斜率序列本身可能更为方便.更复杂的情形,可能需要同时维护每段斜率的大小和该段的长度.无论具体维护方式是什么,这类问题的本质都是利用状态转移中斜率序列变化较少这一点简化转移.因此,它们都可以称作 Slope Trick.
凸函数
在讨论具体的题目之前,有必要首先了解一下凸函数的基本性质,以及在对凸函数进行各种变换时,它的斜率会如何变化.
实轴上的凸函数
凸函数较为一般的定义是在 R \mathbf R R
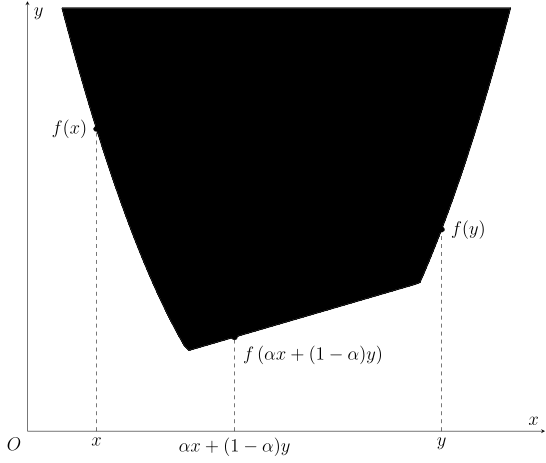
R \mathbf R R 如果函数 f : R → R ∪ { ± ∞ } f:\mathbf R\rightarrow\mathbf R\cup\{\pm\infty\} f : R → R ∪ { ± ∞ } x , y ∈ R x,y\in\mathbf R x , y ∈ R α ∈ ( 0 , 1 ) \alpha\in(0,1) α ∈ ( 0 , 1 )
f ( α x + ( 1 − α ) y ) ≤ α f ( x ) + ( 1 − α ) f ( y ) , f(\alpha x+(1-\alpha)y) \le \alpha f(x)+(1-\alpha)f(y), f ( α x + ( 1 − α ) y ) ≤ α f ( x ) + ( 1 − α ) f ( y ) , 就称函数 f f f 凸函数 (convex function),其中 ± ∞ \pm\infty ± ∞ ± ∞ \pm\infty ± ∞ x ∈ R x\in\mathbf R x ∈ R − ∞ < x < + ∞ -\infty<x<+\infty − ∞ < x < + ∞
当然,如果不等号换作 ≥ \ge ≥ 1 f f f − f -f − f
本文只考虑正常凸函数
为了避免讨论 ∞ − ∞ \infty-\infty ∞ − ∞ − ∞ -\infty − ∞ + ∞ +\infty + ∞ 正常凸函数 (proper convex function).这对于理解算法竞赛涉及的内容已经足够.
当然,函数 f f f f f f R \mathbf R R R \mathbf R R
f ~ ( x ) = { f ( x ) , x ∈ dom f , + ∞ , x ∉ dom f . \tilde f(x) = \begin{cases} f(x), & x\in\operatorname{dom}f,\\ +\infty,& x\notin\operatorname{dom}f.\end{cases} f ~ ( x ) = { f ( x ) , + ∞ , x ∈ dom f , x ∈ / dom f . 此时,称 f f f f ~ \tilde f f ~ R \mathbf R R f f f R \mathbf R R
简单例子
常见的凸函数的例子包括:
常数函数:f ( x ) = c f(x)=c f ( x ) = c c ∈ R c\in\mathbf R c ∈ R
一次函数:f ( x ) = k x + b f(x)=kx+b f ( x ) = k x + b k , b ∈ R k,b\in\mathbf R k , b ∈ R k ≠ 0 k\neq 0 k = 0
绝对值函数:f ( x ) = ∣ x − a ∣ f(x)=|x-a| f ( x ) = ∣ x − a ∣ a ∈ R a\in\mathbf R a ∈ R
任何凸函数限制在某个区间上的结果,例如 0 [ a , b ] ( x ) 0_{[a,b]}(x) 0 [ a , b ] ( x ) [ a , b ] [a,b] [ a , b ]
当然,可以通过下文提到的保持凸性的变换组合出更为复杂的凸函数.
离散点集上的凸函数
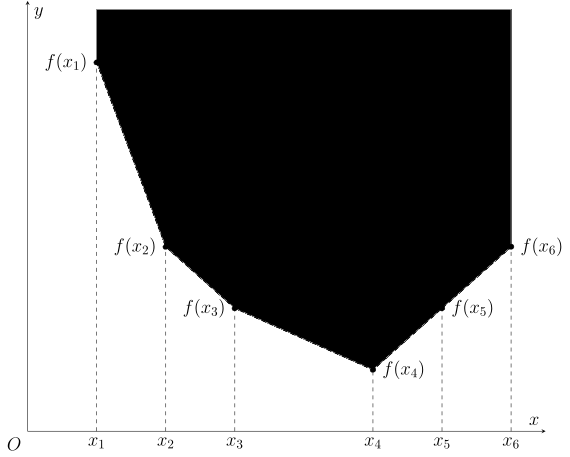
算法竞赛中,很多函数仅在部分整数值处有定义.它们在一般情况下并不是(上文定义的)凸函数,因为它们的定义域不再是凸集.为了处理这种情形,需要单独定义离散点集上的函数的凸性.简单来说,需要首先对函数做线性插值,将其定义域拓展到区间,再判断它的凸性.
离散点集上的凸函数
设 S ⊂ R S\subset\mathbf R S ⊂ R [ a , b ] [a,b] [ a , b ] S ∩ [ a , b ] S\cap[a,b] S ∩ [ a , b ] f : S → R ∪ { ± ∞ } f:S\rightarrow\mathbf R\cup\{\pm\infty\} f : S → R ∪ { ± ∞ } f ~ : R → R ∪ { ± ∞ } \tilde f:\mathbf R\rightarrow\mathbf R\cup\{\pm\infty\} f ~ : R → R ∪ { ± ∞ }
当 x ∈ S x\in S x ∈ S f ~ ( x ) = f ( x ) \tilde f(x)=f(x) f ~ ( x ) = f ( x )
当 x ∈ ( inf S , sup S ) ∖ S x\in(\inf S,\sup S)\setminus S x ∈ ( inf S , sup S ) ∖ S s − = max { s ∈ S : s ≤ x } s_-=\max\{s\in S:s\le x\} s − = max { s ∈ S : s ≤ x } s + = min { s ∈ S : s ≥ x } s_+=\min\{s\in S:s\ge x\} s + = min { s ∈ S : s ≥ x }
f ~ ( x ) = s + − x s + − s − f ( s − ) + x − s − s + − s − f ( s + ) , \tilde f(x) = \dfrac{s_+-x}{s_+-s_-}f(s_-)+\dfrac{x-s_-}{s_+-s_-}f(s_+), f ~ ( x ) = s + − s − s + − x f ( s − ) + s + − s − x − s − f ( s + ) ,
当 x ∉ [ inf S , sup S ] x\notin[\inf S,\sup S] x ∈ / [ inf S , sup S ] f ~ ( x ) = + ∞ \tilde f(x)=+\infty f ~ ( x ) = + ∞
那么,如果 f ~ ( x ) \tilde f(x) f ~ ( x ) R \mathbf R R f ( x ) f(x) f ( x ) S S S 凸函数 .
因为 R \mathbf R R R \mathbf R R f ~ \tilde f f ~ f ~ \tilde f f ~
整数集 Z \mathbf Z Z
Z \mathbf Z Z 函数 f : Z → R ∪ { ± ∞ } f:\mathbf Z\rightarrow\mathbf R\cup\{\pm\infty\} f : Z → R ∪ { ± ∞ }
f ( x ) − f ( x − 1 ) ≤ f ( x + 1 ) − f ( x ) f(x)-f(x-1)\le f(x+1)-f(x) f ( x ) − f ( x − 1 ) ≤ f ( x + 1 ) − f ( x ) 对于所有 x ∈ Z x\in\mathbf Z x ∈ Z
证明
这个命题是凸函数的斜率刻画的简单推论.
如果 f f f Z \mathbf Z Z
Δ f ( x − 1 , x ) ≤ Δ f ( x − 1 , x + 1 ) ≤ Δ f ( x , x + 1 ) . \Delta f(x-1,x)\le \Delta f(x-1,x+1) \le\Delta f(x,x+1). Δ f ( x − 1 , x ) ≤ Δ f ( x − 1 , x + 1 ) ≤ Δ f ( x , x + 1 ) . 这就是上述条件.
反过来,如果上述条件成立,那么对于任何 x 1 < x 2 x_1<x_2 x 1 < x 2
Δ f ( x 1 , x 2 ) = 1 x 2 − x 1 ∑ i = x 1 x 2 − 1 ( f ( i ) − f ( i − 1 ) ) . \Delta f(x_1,x_2) = \dfrac{1}{x_2-x_1}\sum_{i=x_1}^{x_2-1}\left(f(i)-f(i-1)\right). Δ f ( x 1 , x 2 ) = x 2 − x 1 1 i = x 1 ∑ x 2 − 1 ( f ( i ) − f ( i − 1 ) ) . 这相当于对所有满足 x 1 ≤ i < x 2 x_1\le i<x_2 x 1 ≤ i < x 2 x 2 x_2 x 2 x 1 x_1 x 1 Δ f ( x 1 , x 2 ) \Delta f(x_1,x_2) Δ f ( x 1 , x 2 ) f f f Z \mathbf Z Z
也就是说,只要斜率(差分)单调不减,这个序列就可以看作是 Z \mathbf Z Z
凸函数的两种刻画
其实,用斜率刻画凸函数的方式也可以推广到一般情况.
凸函数的斜率刻画
设 S S S R \mathbf R R f : S → R ∪ { ± ∞ } f:S\rightarrow\mathbf R\cup\{\pm\infty\} f : S → R ∪ { ± ∞ }
Δ f ( x 1 , x 2 ) = f ( x 2 ) − f ( x 1 ) x 2 − x 1 \Delta f(x_1,x_2) = \dfrac{f(x_2)-f(x_1)}{x_2-x_1} Δ f ( x 1 , x 2 ) = x 2 − x 1 f ( x 2 ) − f ( x 1 ) 对于任何 x 1 , x 2 ∈ S x_1,x_2\in S x 1 , x 2 ∈ S x 1 < x 2 x_1<x_2 x 1 < x 2 x 1 x_1 x 1 x 2 x_2 x 2
证明
对于 R \mathbf R R f ( x ) f(x) f ( x ) x 1 < x 2 x_1<x_2 x 1 < x 2 α ∈ ( 0 , 1 ) \alpha\in(0,1) α ∈ ( 0 , 1 ) x 3 = α x 1 + ( 1 − α ) x 2 x_3=\alpha x_1+(1-\alpha)x_2 x 3 = α x 1 + ( 1 − α ) x 2
Δ f ( x 1 , x 3 ) ≤ Δ f ( x 1 , x 2 ) ≤ Δ f ( x 3 , x 2 ) \Delta f(x_1,x_3) \le \Delta f(x_1,x_2) \le \Delta f(x_3,x_2) Δ f ( x 1 , x 3 ) ≤ Δ f ( x 1 , x 2 ) ≤ Δ f ( x 3 , x 2 ) 就等价于
f ( x 3 ) − f ( x 1 ) 1 − α ≤ f ( x 2 ) − f ( x 1 ) ≤ f ( x 2 ) − f ( x 3 ) α . \dfrac{f(x_3)-f(x_1)}{1-\alpha} \le f(x_2)-f(x_1) \le \dfrac{f(x_2)-f(x_3)}{\alpha}. 1 − α f ( x 3 ) − f ( x 1 ) ≤ f ( x 2 ) − f ( x 1 ) ≤ α f ( x 2 ) − f ( x 3 ) . 这两侧的不等式都等价于 f ( x 3 ) ≤ α f ( x 1 ) + ( 1 − α ) f ( x 2 ) f(x_3)\le\alpha f(x_1)+(1-\alpha)f(x_2) f ( x 3 ) ≤ α f ( x 1 ) + ( 1 − α ) f ( x 2 ) f ( x ) f(x) f ( x )
对于 R \mathbf R R S S S f ( x ) f(x) f ( x ) f ~ ( x ) \tilde f(x) f ~ ( x ) Δ f ~ ( x 1 , x 2 ) \Delta\tilde f(x_1,x_2) Δ f ~ ( x 1 , x 2 ) S = { s i } S=\{s_i\} S = { s i } s i s_i s i i i i s i 1 ≤ x 1 ≤ s i 1 + 1 s_{i_1}\le x_1\le s_{i_1+1} s i 1 ≤ x 1 ≤ s i 1 + 1 s i 2 ≤ x 2 ≤ s i 2 + 1 s_{i_2}\le x_2\le s_{i_2+1} s i 2 ≤ x 2 ≤ s i 2 + 1 i 1 ≤ i 2 i_1\le i_2 i 1 ≤ i 2 Δ i = Δ f ( s i , s i + 1 ) \Delta_i=\Delta f(s_i,s_{i+1}) Δ i = Δ f ( s i , s i + 1 ) Δ i 1 ≤ Δ f ~ ( x 1 , x 2 ) ≤ Δ i 2 \Delta_{i_1}\le\Delta\tilde f(x_1,x_2)\le\Delta_{i_2} Δ i 1 ≤ Δ f ~ ( x 1 , x 2 ) ≤ Δ i 2
这分两种情形.如果 i 1 = i 2 i_1=i_2 i 1 = i 2 Δ i 1 = Δ f ~ ( x 1 , x 2 ) = Δ i 2 \Delta_{i_1}=\Delta\tilde f(x_1,x_2)=\Delta_{i_2} Δ i 1 = Δ f ~ ( x 1 , x 2 ) = Δ i 2
Δ f ~ ( x 1 , x 2 ) = 1 x 2 − x 1 ( ( s i 1 + 1 − x 1 ) Δ i 1 + ( x 2 − s i 2 ) Δ i 2 + ∑ j = i 1 + 1 i 2 − 1 ( s j + 1 − s j ) Δ j ) . \Delta\tilde f(x_1,x_2) = \dfrac{1}{x_2-x_1}\left((s_{i_1+1}-x_1)\Delta_{i_1}+(x_2-s_{i_2})\Delta_{i_2}+\sum_{j=i_1+1}^{i_2-1}(s_{j+1}-s_j)\Delta_j\right). Δ f ~ ( x 1 , x 2 ) = x 2 − x 1 1 ( ( s i 1 + 1 − x 1 ) Δ i 1 + ( x 2 − s i 2 ) Δ i 2 + j = i 1 + 1 ∑ i 2 − 1 ( s j + 1 − s j ) Δ j ) . 根据 S S S Δ i \Delta_i Δ i i i i Δ i 1 ≤ Δ f ~ ( x 1 , x 2 ) ≤ Δ i 2 \Delta_{i_1}\le\Delta\tilde f(x_1,x_2)\le\Delta_{i_2} Δ i 1 ≤ Δ f ~ ( x 1 , x 2 ) ≤ Δ i 2
利用这个结论,对于 x 1 < x 2 x_1<x_2 x 1 < x 2 α ∈ ( 0 , 1 ) \alpha\in(0,1) α ∈ ( 0 , 1 ) x 3 = α x 1 + ( 1 − α ) x 2 x_3=\alpha x_1+(1-\alpha)x_2 x 3 = α x 1 + ( 1 − α ) x 2 i 3 i_3 i 3 s i 3 ≤ x 3 ≤ s i 3 + 1 s_{i_3}\le x_3\le s_{i_3+1} s i 3 ≤ x 3 ≤ s i 3 + 1
Δ f ~ ( x 1 , x 3 ) ≤ Δ i 3 ≤ Δ f ~ ( x 3 , x 2 ) . \Delta\tilde f(x_1,x_3) \le \Delta_{i_3} \le \Delta\tilde f(x_3,x_2). Δ f ~ ( x 1 , x 3 ) ≤ Δ i 3 ≤ Δ f ~ ( x 3 , x 2 ) . 代入 x 3 x_3 x 3 f ~ ( x ) \tilde f(x) f ~ ( x )
斜率单调不减,可以看作是凸函数的等价定义.正因为凸函数的斜率具有单调性,在维护斜率时,通常需要选择 堆(优先队列) 或 平衡树 等数据结构.
本文还会用到凸函数的另一种等价刻画.对于函数 f : R → R ∪ { ± ∞ } f:\mathbf R\rightarrow\mathbf R\cup\{\pm\infty\} f : R → R ∪ { ± ∞ }
epi f = { ( x , y ) ∈ R 2 : y ≥ f ( x ) } . \operatorname{epi} f = \{(x,y)\in\mathbf R^2 : y\ge f(x)\}. epi f = {( x , y ) ∈ R 2 : y ≥ f ( x )} . 这个区域也称为函数 f f f 上境图 (epigraph).函数的凸性,等价于它的上境图的凸性:
凸函数的上境图刻画
函数 f : R → R ∪ { ± ∞ } f:\mathbf R\rightarrow\mathbf R\cup\{\pm\infty\} f : R → R ∪ { ± ∞ } epi f \operatorname{epi}f epi f R 2 \mathbf R^2 R 2
证明
如果 f f f ( x 1 , y 1 ) , ( x 2 , y 2 ) ∈ epi f (x_1,y_1),(x_2,y_2)\in\operatorname{epi}f ( x 1 , y 1 ) , ( x 2 , y 2 ) ∈ epi f α ∈ ( 0 , 1 ) \alpha\in(0,1) α ∈ ( 0 , 1 )
α y 1 + ( 1 − α ) y 2 ≥ α f ( x 1 ) + ( 1 − α ) f ( x 2 ) ≥ f ( α x 1 + ( 1 − α ) x 2 ) . \alpha y_1+(1-\alpha)y_2 \ge \alpha f(x_1)+(1-\alpha)f(x_2) \ge f(\alpha x_1+(1-\alpha) x_2). α y 1 + ( 1 − α ) y 2 ≥ α f ( x 1 ) + ( 1 − α ) f ( x 2 ) ≥ f ( α x 1 + ( 1 − α ) x 2 ) . 所以,α ( x 1 , y 1 ) + ( 1 − α ) ( x 2 , y 2 ) ∈ epi f \alpha(x_1,y_1)+(1-\alpha)(x_2,y_2)\in\operatorname{epi}f α ( x 1 , y 1 ) + ( 1 − α ) ( x 2 , y 2 ) ∈ epi f
反过来,如果 epi f \operatorname{epi}f epi f x 1 < x 2 x_1<x_2 x 1 < x 2 α ∈ ( 0 , 1 ) \alpha\in(0,1) α ∈ ( 0 , 1 )
α ( x 1 , f ( x 1 ) ) + ( 1 − α ) ( x 2 , f ( x 2 ) ) ∈ epi f . \alpha(x_1,f(x_1))+(1-\alpha)(x_2,f(x_2)) \in \operatorname{epi}f. α ( x 1 , f ( x 1 )) + ( 1 − α ) ( x 2 , f ( x 2 )) ∈ epi f . 这就等价于 α f ( x 1 ) + ( 1 − α ) f ( x 2 ) ≥ f ( α x 1 + ( 1 − α ) x 2 ) \alpha f(x_1)+(1-\alpha)f(x_2)\ge f\left(\alpha x_1+(1-\alpha)x_2\right) α f ( x 1 ) + ( 1 − α ) f ( x 2 ) ≥ f ( α x 1 + ( 1 − α ) x 2 ) f f f
稍后会看到,利用上境图,可以将凸函数的卷积下确界与凸集的 Minkowski 和联系起来.
凸函数的变换
紧接着,本文介绍一些 Slope Trick 中经常遇见的保持凸性的变换.
非负线性组合
对于凸函数 f f f g g g α , β ≥ 0 \alpha,\beta\ge0 α , β ≥ 0 α f + β g \alpha f+\beta g α f + β g
Δ ( α f + β g ) = α Δ f + β Δ g . \Delta(\alpha f+\beta g) = \alpha\Delta f + \beta\Delta g. Δ ( α f + β g ) = α Δ f + β Δ g . 因此,如果维护了凸函数 f f f g g g α f + β g \alpha f+\beta g α f + β g
在维护斜率的问题中,往往其中一个函数的形式比较简单,此时可以通过懒标记的方式降低修改复杂度.在维护拐点的问题中,要计算 f + g f+g f + g f f f g g g
卷积下确界(Minkowski 和)
凸函数的另一种常见操作是卷积下确界.对于函数 f f f g g g
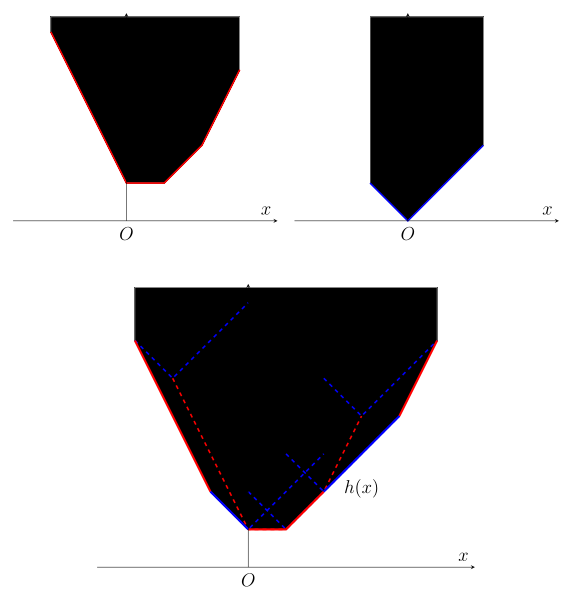
h ( x ) = inf y ∈ R f ( y ) + g ( x − y ) h(x) = \inf_{y\in\mathbf R}f(y)+g(x-y) h ( x ) = y ∈ R inf f ( y ) + g ( x − y ) 称为 f f f g g g 卷积下确界 2 f f f g g g
对图示的解释
如图所示,要求 f f f g g g h h h f f f g g g f f f g g g h h h h h h f f f g g g f f f g g g f f f g g g
几何直观上,epi h \operatorname{epi}h epi h epi f \operatorname{epi}f epi f epi g \operatorname{epi}g epi g Minkowski 和 .如果 f f f g g g h h h f f f g g g
证明
设 f , g f,g f , g h h h x 1 < x 2 x_1<x_2 x 1 < x 2 α ∈ ( 0 , 1 ) \alpha\in(0,1) α ∈ ( 0 , 1 ) ε > 0 \varepsilon>0 ε > 0 y i , z i ∈ R y_i,z_i\in\mathbf R y i , z i ∈ R y i + z i = x i y_i+z_i=x_i y i + z i = x i
h ( x i ) + ε > f ( y i ) + g ( z i ) . h(x_i) + \varepsilon > f(y_i) + g(z_i). h ( x i ) + ε > f ( y i ) + g ( z i ) . 故而,结合 f , g f,g f , g h h h
α h ( x 1 ) + ( 1 − α ) h ( x 2 ) + ε > α f ( y 1 ) + ( 1 − α ) f ( y 2 ) + α g ( z 1 ) + ( 1 − α ) g ( z 2 ) ≥ f ( α y 1 + ( 1 − α ) y 2 ) + g ( α z 1 + ( 1 − α ) z 2 ) ≥ h ( α x 1 + ( 1 − α ) x 2 ) . \begin{aligned}
\alpha h(x_1)+(1-\alpha)h(x_2) + \varepsilon
&> \alpha f(y_1) + (1-\alpha) f(y_2) + \alpha g(z_1) + (1-\alpha) g(z_2)\\
&\ge f\left(\alpha y_1+(1-\alpha)y_2\right) + g\left(\alpha z_1+(1-\alpha)z_2\right)\\
&\ge h(\alpha x_1+(1-\alpha)x_2).
\end{aligned} α h ( x 1 ) + ( 1 − α ) h ( x 2 ) + ε > α f ( y 1 ) + ( 1 − α ) f ( y 2 ) + α g ( z 1 ) + ( 1 − α ) g ( z 2 ) ≥ f ( α y 1 + ( 1 − α ) y 2 ) + g ( α z 1 + ( 1 − α ) z 2 ) ≥ h ( α x 1 + ( 1 − α ) x 2 ) . 因为 ε > 0 \varepsilon>0 ε > 0
α h ( x 1 ) + ( 1 − α ) h ( x 2 ) ≥ h ( α x 1 + ( 1 − α ) x 2 ) . \alpha h(x_1)+(1-\alpha)h(x_2) \ge h(\alpha x_1+(1-\alpha)x_2). α h ( x 1 ) + ( 1 − α ) h ( x 2 ) ≥ h ( α x 1 + ( 1 − α ) x 2 ) . 这就得到 h h h
然后,对于几何直观,严格地说,只能证明如下结论:
epi f + epi g ⊆ epi h ⊆ cl ( epi f + epi g ) . \operatorname{epi} f + \operatorname{epi} g\subseteq \operatorname{epi}h \subseteq \operatorname{cl}(\operatorname{epi} f + \operatorname{epi} g). epi f + epi g ⊆ epi h ⊆ cl ( epi f + epi g ) . 其中,cl \operatorname{cl} cl
对于任何 ( x , y ) ∈ epi f + epi g (x,y)\in\operatorname{epi} f + \operatorname{epi} g ( x , y ) ∈ epi f + epi g ( x 1 , y 1 ) ∈ epi f (x_1,y_1)\in\operatorname{epi} f ( x 1 , y 1 ) ∈ epi f ( x 2 , y 2 ) ∈ epi g (x_2,y_2)\in\operatorname{epi} g ( x 2 , y 2 ) ∈ epi g x = x 1 + x 2 x=x_1+x_2 x = x 1 + x 2
y = y 1 + y 2 ≥ f ( x 1 ) + g ( x 2 ) ≥ h ( x 1 + x 2 ) = h ( x ) . y = y_1+y_2 \ge f(x_1)+g(x_2) \ge h(x_1+x_2)=h(x). y = y 1 + y 2 ≥ f ( x 1 ) + g ( x 2 ) ≥ h ( x 1 + x 2 ) = h ( x ) . 故而,( x , y ) ∈ epi h (x,y)\in\operatorname{epi}h ( x , y ) ∈ epi h epi f + epi g ⊆ epi h \operatorname{epi} f + \operatorname{epi} g\subseteq \operatorname{epi}h epi f + epi g ⊆ epi h
反过来,对于任何 ( x , y ) ∈ epi h (x,y)\in\operatorname{epi}h ( x , y ) ∈ epi h y ≥ h ( x ) y\ge h(x) y ≥ h ( x ) h h h ε > 0 \varepsilon>0 ε > 0 x 1 + x 2 = x x_1+x_2=x x 1 + x 2 = x
y + ε > f ( x 1 ) + g ( x 2 ) . y + \varepsilon > f(x_1) + g(x_2). y + ε > f ( x 1 ) + g ( x 2 ) . 令 y 1 = f ( x 1 ) y_1=f(x_1) y 1 = f ( x 1 ) y 2 = g ( x 2 ) y_2=g(x_2) y 2 = g ( x 2 ) y + ε > y 1 + y 2 y+\varepsilon>y_1+y_2 y + ε > y 1 + y 2 ε > 0 \varepsilon>0 ε > 0 ( x 1 , y 1 ) + ( x 2 , y 2 ) ∈ epi f + epi g (x_1,y_1)+(x_2,y_2)\in\operatorname{epi} f + \operatorname{epi} g ( x 1 , y 1 ) + ( x 2 , y 2 ) ∈ epi f + epi g ( x , y ) (x,y) ( x , y ) ( x , y + ε ) (x,y+\varepsilon) ( x , y + ε ) ε → 0 \varepsilon\rightarrow 0 ε → 0 epi h ⊆ cl ( epi f + epi g ) \operatorname{epi}h \subseteq \operatorname{cl}(\operatorname{epi} f + \operatorname{epi} g) epi h ⊆ cl ( epi f + epi g )
所以,epi f + epi g = epi h \operatorname{epi} f + \operatorname{epi} g = \operatorname{epi}h epi f + epi g = epi h f f f g g g 下半连续 .对于算法竞赛的应用来说,这已经足够了,比如分段线性函数总是满足这些条件的.
在实际问题中,如果 f f f g g g 启发式合并 或 可并堆 等方法,降低合并的整体复杂度,或者根据具体问题寻找相应的处理方式.
最值操作
两个凸函数的最大值仍然是凸函数,但是,两个凸函数的最小值未必仍然是凸函数.
很多常见的最小值操作可以转化为卷积下确界:
例子
f ( x ) = min y ∈ [ x + a , x + b ] g ( y ) f(x)=\min_{y\in [x+a,x+b]}g(y) f ( x ) = min y ∈ [ x + a , x + b ] g ( y )
f ( x ) = min y ∈ R g ( y ) + 0 [ − b , − a ] ( x − y ) . f(x) = \min_{y\in\mathbf R}g(y) + 0_{[-b,-a]}(x-y). f ( x ) = y ∈ R min g ( y ) + 0 [ − b , − a ] ( x − y ) .
f ( x ) = min { g ( x − a i ) + b i } f(x)=\min\{g(x-a_i)+b_i\} f ( x ) = min { g ( x − a i ) + b i } Z \mathbf Z Z g ( x ) g(x) g ( x ) Z \mathbf Z Z { a i } ⊂ Z \{a_i\}\subset\mathbf Z { a i } ⊂ Z h : a i ↦ b i h:a_i\mapsto b_i h : a i ↦ b i f ~ ( x ) \tilde f(x) f ~ ( x )
f ~ ( x ) = min y ∈ R h ~ ( y ) + g ~ ( x − y ) . \tilde f(x) = \min_{y\in\mathbf R}\tilde h(y)+\tilde g(x-y). f ~ ( x ) = y ∈ R min h ~ ( y ) + g ~ ( x − y ) . 因此,延拓之前的函数 f ( x ) f(x) f ( x )
但并不是所有的最小值操作都保持凸性.
反例
设 g ( x ) g(x) g ( x ) f ( x ) = min { g ( x − 1 ) + k x , g ( x ) } f(x)=\min\{g(x-1)+kx,g(x)\} f ( x ) = min { g ( x − 1 ) + k x , g ( x )}
在一些特殊的问题中,尽管动态规划的转移方程可以写作两个凸函数的最小值的形式,且难以转化为卷积下确界的形式,但是价值函数依然能够保持凸性.在实际处理时,通常需要结合打表和猜测找到这类问题的合理的斜率转移方式.
了解了凸函数及其常见变换后,就可以通过具体的问题理解 Slope Trick 优化 DP 的方法.本文的例题大致分为维护拐点和维护斜率两组,用于理解这两种维护方式的常见操作和实施细节.但是,正如前文所强调的那样,维护方式并不是 Slope Trick 的本质,应当根据具体的问题需要选取合适的斜率段维护方式.
维护拐点
这类问题通常出现在需要最小化若干个绝对值的和式的问题中.因为这类问题中,价值函数的斜率的绝对值并不大,因此维护斜率变化的拐点更为方便.
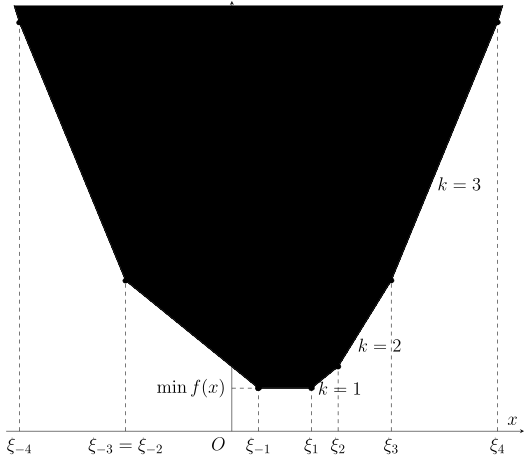
维护拐点是指维护分段线性函数中,斜率发生变化的点.相当于对于每个斜率为 k i k_i k i [ l i , r i ] [l_i,r_i] [ l i , r i ] ξ − s ≤ ⋯ ≤ ξ − 1 ≤ ξ 1 ≤ ⋯ ≤ ξ t \xi_{-s}\le\cdots\le\xi_{-1}\le\xi_{1}\le\cdots\le\xi_{t} ξ − s ≤ ⋯ ≤ ξ − 1 ≤ ξ 1 ≤ ⋯ ≤ ξ t [ ξ − 1 , ξ 1 ] [\xi_{-1},\xi_1] [ ξ − 1 , ξ 1 ] 0 0 0 [ ξ 2 , ξ 3 ] [\xi_2,\xi_3] [ ξ 2 , ξ 3 ] 2 2 2 [ ξ − 3 , ξ − 2 ] [\xi_{-3},\xi_{-2}] [ ξ − 3 , ξ − 2 ] − 2 -2 − 2
f ( x ) = f ( ξ 1 ) + ∑ i = − s − 1 max { ξ i − x , 0 } + ∑ i = 1 ℓ max { x − ξ i , 0 } . f(x) = f(\xi_1) + \sum_{i=-s}^{-1}\max\{\xi_i-x,0\} + \sum_{i=1}^{\ell}\max\{x-\xi_i,0\}. f ( x ) = f ( ξ 1 ) + i = − s ∑ − 1 max { ξ i − x , 0 } + i = 1 ∑ ℓ max { x − ξ i , 0 } . 它的最小值就是 f ( ξ − 1 ) = f ( ξ 1 ) f(\xi_{-1})=f(\xi_1) f ( ξ − 1 ) = f ( ξ 1 ) [ ξ − 1 , ξ 1 ] [\xi_{-1},\xi_1] [ ξ − 1 , ξ 1 ]
例题:最小成本递增序列
[BalticOI 2004] Sequence 数字序列 给定长度为 n n n { a i } \{a_i\} { a i } { b i } \{b_i\} { b i } ∑ i ∣ a i − b i ∣ \sum_i|a_i-b_i| ∑ i ∣ a i − b i ∣ { b i } \{b_i\} { b i }
解答
首先,{ b i } \{b_i\} { b i } { b i ′ } = { b i − i } \{b'_i\}=\{b_i-i\} { b i ′ } = { b i − i } { a i ′ } = { a i − i } \{a'_i\}=\{a_i-i\} { a i ′ } = { a i − i } { b i ′ } = { b i − i } \{b'_i\}=\{b_i-i\} { b i ′ } = { b i − i } { b i } \{b_i\} { b i }
考虑朴素 DP 解法.设 f i ( x ) f_i(x) f i ( x ) { b i ′ } \{b'_i\} { b i ′ } i i i i i i x x x { a i ′ } \{a'_i\} { a i ′ } i i i
f i ( x ) = min ∑ j = 1 i ∣ a j ′ − b j ′ ∣ s.t. b 1 ′ ≤ b 2 ′ ≤ ⋯ ≤ b i ′ ≤ x . f_i(x) = \min\sum_{j=1}^i|a'_j-b'_j|\text{ s.t. }b'_1\le b'_2\le\cdots\le b'_i\le x. f i ( x ) = min j = 1 ∑ i ∣ a j ′ − b j ′ ∣ s.t. b 1 ′ ≤ b 2 ′ ≤ ⋯ ≤ b i ′ ≤ x . 容易得到状态转移方程为
f i ( x ) = min y ≤ x f i − 1 ( y ) + ∣ a i ′ − y ∣ . f_i(x) = \min_{y\le x}f_{i-1}(y)+|a'_i-y|. f i ( x ) = y ≤ x min f i − 1 ( y ) + ∣ a i ′ − y ∣. 初始状态为 f 0 ( x ) ≡ 0 f_0(x)\equiv 0 f 0 ( x ) ≡ 0 min x f n ( x ) \min_xf_n(x) min x f n ( x ) f i − 1 ( x ) f_{i-1}(x) f i − 1 ( x ) f i ( x ) f_i(x) f i ( x )
首先,加上 ∣ a i ′ − x ∣ |a'_i-x| ∣ a i ′ − x ∣ ( − ∞ , a i ′ ] (-\infty,a'_i] ( − ∞ , a i ′ ] − 1 -1 − 1 [ a i ′ , + ∞ ) [a'_i,+\infty) [ a i ′ , + ∞ ) 1 1 1
对得到的函数取最小值,将 g ( x ) = f i − 1 ( x ) + ∣ a i ′ − x ∣ g(x)=f_{i-1}(x)+|a'_i-x| g ( x ) = f i − 1 ( x ) + ∣ a i ′ − x ∣ f i ( x ) = min y ≤ x g ( y ) f_i(x)=\min_{y\le x}g(y) f i ( x ) = min y ≤ x g ( y ) g ( x ) g(x) g ( x ) 0 [ 0 , + ∞ ) 0_{[0,+\infty)} 0 [ 0 , + ∞ ) 0 0 0 g ( x ) g(x) g ( x )
明晰了这些操作后,已经可以直接用平衡树维护所有斜率段了,但代码较复杂.注意到问题中斜率每次变化至多 1 1 1 n n n
设 f − 1 ( x ) f_{-1}(x) f − 1 ( x ) ξ − k ≤ ⋯ ≤ ξ − 1 ≤ ξ 1 ≤ ⋯ ≤ ξ ℓ \xi_{-k}\le\cdots\le\xi_{-1}\le\xi_{1}\le\cdots\le\xi_{\ell} ξ − k ≤ ⋯ ≤ ξ − 1 ≤ ξ 1 ≤ ⋯ ≤ ξ ℓ
增加一个负斜率段的拐点 a i ′ a'_i a i ′ a i ′ a'_i a i ′
弹出所有正斜率段的拐点 ξ 1 , ⋯ , ξ ℓ \xi_1,\cdots,\xi_{\ell} ξ 1 , ⋯ , ξ ℓ
实际维护时,因为每次操作结束后都没有正斜率段的拐点,即斜率拐点具有形式 ξ − k ≤ ⋯ ≤ ξ − 1 \xi_{-k}\le\cdots\le\xi_{-1} ξ − k ≤ ⋯ ≤ ξ − 1
插入两次 a i ′ a'_i a i ′
弹出堆顶.
当然,每次结束后都需要维护当前函数的最小值.因为操作结束后,没有正斜率段,函数最小值就是它在最大堆堆顶处的取值.设每次操作之前堆顶为 ξ − 1 \xi_{-1} ξ − 1 f i − 1 ( ξ − 1 ) f_{i-1}(\xi_{-1}) f i − 1 ( ξ − 1 )
f i − 1 ( max { a i ′ , ξ − 1 } ) + ∣ max { a i ′ , ξ − 1 } − a i ′ ∣ = f i − 1 ( ξ − 1 ) + max { 0 , ξ − 1 − a i ′ } . f_{i-1}(\max\{a'_i,\xi_{-1}\})+|\max\{a'_i,\xi_{-1}\}-a'_i|=f_{i-1}(\xi_{-1})+\max\{0,\xi_{-1}-a'_i\}. f i − 1 ( max { a i ′ , ξ − 1 }) + ∣ max { a i ′ , ξ − 1 } − a i ′ ∣ = f i − 1 ( ξ − 1 ) + max { 0 , ξ − 1 − a i ′ } . 其中,第一项相等是因为 f i − 1 ( x ) f_{i-1}(x) f i − 1 ( x ) max { 0 , ξ − 1 − a i ′ } \max\{0,\xi_{-1}-a'_i\} max { 0 , ξ − 1 − a i ′ }
本题还要求输出一种最优方案.因为最后操作结束时,最优解就是堆顶,所以 b n ′ b'_n b n ′ i i i b i ′ b'_i b i ′ f i − 1 ( x ) f_{i-1}(x) f i − 1 ( x ) x ≤ b ′ x\le b' x ≤ b ′ f i − 1 ( x ) f_{i-1}(x) f i − 1 ( x ) f i − 1 ( x ) f_{i-1}(x) f i − 1 ( x ) b i ′ b'_i b i ′ b i − 1 ′ b'_{i-1} b i − 1 ′
时间复杂度为 O ( n log n ) O(n\log n) O ( n log n )
#include <iostream>
#include <queue>
#include <vector>
int main () int n;
std::cin >> n;
std::vector<int > a (n) , b (n) ;
for (int & x : a) std::cin >> x;
for (int i = 0 ; i < n; ++i) a[i] -= i;
long long res = 0 ;
std::priority_queue<int > max_heap;
for (int i = 0 ; i < n; ++i) {
max_heap.emplace (a[i]);
max_heap.emplace (a[i]);
res += max_heap.top () - a[i];
max_heap.pop ();
b[i] = max_heap.top ();
}
std::cout << res << '\n' ;
for (int i = n - 2 ; i >= 0 ; --i) b[i] = std::min (b[i], b[i + 1 ]);
for (int i = 0 ; i < n; ++i)
std::cout << (b[i] + i) << (i == n - 1 ? '\n' : ' ' );
return 0 ;
}
模板题:
例题:转移带限制的情形
[NOISG 2018 Finals] Safety 给定长度为 n n n { a i } \{a_i\} { a i } { b i } \{b_i\} { b i } ∣ b i − b i − 1 ∣ ≤ h |b_i-b_{i-1}|\le h ∣ b i − b i − 1 ∣ ≤ h
内容大致与上一个题目相仿,只是序列 { b i } \{b_i\} { b i } f i ( x ) f_i(x) f i ( x ) i i i x x x i i i
f i ( x ) = min ∑ j = 1 i ∣ a j − b j ∣ s.t. ∣ b j − 1 − b j ∣ ≤ h , ∀ 1 < j ≤ i , b i = x . f_i(x) = \min\sum_{j=1}^i|a_j-b_j|\text{ s.t. }|b_{j-1}-b_j|\le h,\forall 1<j\le i,~b_i=x. f i ( x ) = min j = 1 ∑ i ∣ a j − b j ∣ s.t. ∣ b j − 1 − b j ∣ ≤ h , ∀1 < j ≤ i , b i = x . 由此,有状态转移方程为
f i ( x ) = ∣ a i − x ∣ + min ∣ y − x ∣ ≤ h f i − 1 ( y ) . f_i(x) = |a_i-x| + \min_{|y-x|\le h} f_{i-1}(y). f i ( x ) = ∣ a i − x ∣ + ∣ y − x ∣ ≤ h min f i − 1 ( y ) . 起始条件为 f 0 ( x ) ≡ 0 f_0(x)\equiv 0 f 0 ( x ) ≡ 0 min x f n ( x ) \min_xf_n(x) min x f n ( x )
状态转移拆解为对凸函数的操作,分两步:
首先对 f i − 1 ( x ) f_{i-1}(x) f i − 1 ( x ) min ∣ y − x ∣ ≤ h f i − 1 ( y ) \min_{|y-x|\le h} f_{i-1}(y) min ∣ y − x ∣ ≤ h f i − 1 ( y ) f i − 1 ( x ) f_{i-1}(x) f i − 1 ( x ) 0 [ − h , h ] ( x ) 0_{[-h,h]}(x) 0 [ − h , h ] ( x )
再将得到的函数与 ∣ a i − x ∣ |a_i-x| ∣ a i − x ∣
同样因为斜率每次只变化一,可以考虑维护拐点.这样,这两步操作就可以描述为:
将所有负斜率段向左移动 h h h h h h
插入两次 a i a_i a i
显然,对于本题,将正负斜率段分别维护较为方便.因为操作主要集中在零斜率段附近,因此考虑使用 对顶堆 ,即分别用最大堆和最小堆维护负斜率段和正斜率段的拐点.拐点的整体平移操作用懒标记完成.因为第二步操作需要分别对两个堆插入一个 a i a_i a i
最后,考虑操作过程中如何更新最小值.因为第一步平移操作并不会改变最小值,所以只要考虑交换堆顶的操作即可.设 ξ − 1 > ξ 1 \xi_{-1}>\xi_1 ξ − 1 > ξ 1 ξ − 1 \xi_{-1} ξ − 1 ξ 1 \xi_1 ξ 1
max { 0 , x − ξ − 1 } + max { 0 , x − ξ 1 } \max\{0,x-\xi_{-1}\}+\max\{0,x-\xi_1\} max { 0 , x − ξ − 1 } + max { 0 , x − ξ 1 } 变为
max { 0 , x − ξ 1 } + max { 0 , x − ξ − 1 } . \max\{0,x-\xi_{1}\}+\max\{0,x-\xi_{-1}\}. max { 0 , x − ξ 1 } + max { 0 , x − ξ − 1 } . 过程中,函数形状不变,只是向下平移了 ∣ ξ − 1 − ξ 1 ∣ |\xi_{-1}-\xi_1| ∣ ξ − 1 − ξ 1 ∣ ∣ ξ − 1 − ξ 1 ∣ |\xi_{-1}-\xi_1| ∣ ξ − 1 − ξ 1 ∣
算法的时间复杂度仍为 O ( n log n ) O(n\log n) O ( n log n )
#include <iostream>
#include <queue>
#include <vector>
int main () int n;
long long h;
std::cin >> n >> h;
std::priority_queue<long long > max_heap;
std::priority_queue<long long , std::vector<long long >, std::greater<>>
min_heap;
long long lt = 0 , rt = 0 ;
long long res = 0 ;
for (; n; --n) {
long long x;
std::cin >> x;
lt += h;
rt += h;
max_heap.emplace (x + lt);
min_heap.emplace (x - rt);
auto l = max_heap.top () - lt;
auto r = min_heap.top () + rt;
while (l > r) {
max_heap.pop ();
min_heap.pop ();
res += l - r;
max_heap.emplace (r + lt);
min_heap.emplace (l - rt);
l = max_heap.top () - lt;
r = min_heap.top () + rt;
}
}
std::cout << res << std::endl;
return 0 ;
}
模板题:
维护斜率
还有一些问题,维护斜率更为方便.这类问题通常也可以使用 反悔贪心 或模拟费用流的思想解决.费用流模型中,最小费用往往是流量的凸函数,这就为使用 Slope Trick 提供了基础.
例题:股票交易问题
Codeforces 865 D. Buy Low Sell High
给定 n n n { p i } \{p_i\} { p i } 0 0 0 n n n
解答
首先考虑朴素 DP 解法.设 f i ( x ) f_i(x) f i ( x ) i i i x ≥ 0 x\ge 0 x ≥ 0
f i ( x ) = max { f i − 1 ( x − 1 ) − p i , f i − 1 ( x ) , f i − 1 ( x + 1 ) + p i } . f_i(x) = \max\{f_{i-1}(x-1)-p_i,f_{i-1}(x),f_{i-1}(x+1)+p_i\}. f i ( x ) = max { f i − 1 ( x − 1 ) − p i , f i − 1 ( x ) , f i − 1 ( x + 1 ) + p i } . 初始状态为 f 0 ( 0 ) = 0 f_0(0)=0 f 0 ( 0 ) = 0 x ≠ 0 x\neq 0 x = 0 f 0 ( x ) = − ∞ f_0(x)=-\infty f 0 ( x ) = − ∞ f n ( 0 ) f_n(0) f n ( 0 )
从 f i − 1 ( x ) f_{i-1}(x) f i − 1 ( x ) f i ( x ) f_i(x) f i ( x )
将 f i − 1 ( x ) f_{i-1}(x) f i − 1 ( x )
h i ( x ) = { p i , x = − 1 , 0 , x = 0 , − p i , x = 1 h_i(x) = \begin{cases}p_i,&x=-1,\\0,&x=0,\\-p_i,&x=1\end{cases} h i ( x ) = ⎩ ⎨ ⎧ p i , 0 , − p i , x = − 1 , x = 0 , x = 1 对应的分段线性函数 h ~ ( x ) \tilde h(x) h ~ ( x )
因为这样会导致函数在区间 [ − 1 , 0 ) [-1,0) [ − 1 , 0 ) x ≥ 0 x\ge 0 x ≥ 0 [ 0 , + ∞ ) [0,+\infty) [ 0 , + ∞ )
将它们转化为斜率段的变化,就是如下两步:
插入长度为 2 2 2 − p i -p_i − p i
删除斜率有限的斜率段中,斜率最大且长度为 1 1 1
因为斜率段的长度总是自然数,所以不妨维护若干个长度为一的斜率段,从而只需要记录每段的斜率即可.因为只需要插入和访问最大值操作,所以只需要一个最大堆.操作分两步:
插入两次 − p i -p_i − p i
弹出堆顶.
还需要维护 f i ( 0 ) f_i(0) f i ( 0 ) x = − 1 x=-1 x = − 1 f i − 1 ( 0 ) + p i f_{i-1}(0)+p_i f i − 1 ( 0 ) + p i x = 0 x=0 x = 0 [ − 1 , 0 ] [-1,0] [ − 1 , 0 ] x = 0 x=0 x = 0 f i ( 0 ) f_i(0) f i ( 0 )
对比该算法实现与上文 最小成本递增序列 的代码可知,该算法等价于求将股票价格变为弱递减序列的最小成本.
时间复杂度为 O ( n log n ) O(n\log n) O ( n log n )
#include <iostream>
#include <queue>
#include <vector>
int main () int n;
std::cin >> n;
std::vector<int > a (n) ;
for (int & x : a) std::cin >> x;
long long res = 0 ;
std::priority_queue<int > max_heap;
for (int x : a) {
max_heap.emplace (-x);
max_heap.emplace (-x);
res += x + max_heap.top ();
max_heap.pop ();
}
std::cout << res << '\n' ;
return 0 ;
}
模板题:
例题:搬运土石问题
[USACO16OPEN] Landscaping P 给定长度为 n n n { a i } \{a_i\} { a i } { b i } \{b_i\} { b i } i i i X X X Y Y Y i i i j j j Z ∣ i − j ∣ Z|i-j| Z ∣ i − j ∣ a i , b i ≤ 10 a_i,b_i\le 10 a i , b i ≤ 10
解答
考虑朴素 DP 解法.设 f i ( x ) f_i(x) f i ( x ) i i i x x x x < 0 x<0 x < 0 ∣ x ∣ |x| ∣ x ∣
f i ( x ) = min y ∈ R f i − 1 ( y ) + ∣ y ∣ Z + h ( ( x − y ) + ( b i − a i ) ) . f_i(x) = \min_{y\in\mathbf R} f_{i-1}(y) + |y|Z + h((x-y)+(b_i-a_i)). f i ( x ) = y ∈ R min f i − 1 ( y ) + ∣ y ∣ Z + h (( x − y ) + ( b i − a i )) . 其中,函数 h ( δ ) h(\delta) h ( δ ) δ \delta δ
h ( δ ) = max { 0 , δ } X + max { 0 , − δ } Y = max { δ X , − δ Y } . h(\delta) = \max\{0,\delta\}X + \max\{0,-\delta\}Y = \max\{\delta X,-\delta Y\}. h ( δ ) = max { 0 , δ } X + max { 0 , − δ } Y = max { δ X , − δ Y } . 它显然是凸函数.该状态转移方程的含义为
之前 i − 1 i-1 i − 1 y y y f i − 1 ( y ) f_{i-1}(y) f i − 1 ( y )
将净剩余(亏空)的泥土数量在 i i i i − 1 i-1 i − 1 ∣ y ∣ Z |y|Z ∣ y ∣ Z
通过买卖,将第 i i i a i a_i a i b i b_i b i y y y x x x h ( ( x − y ) + ( b i − a i ) ) h((x-y)+(b_i-a_i)) h (( x − y ) + ( b i − a i ))
初始状态为 f 0 ( 0 ) = 0 f_0(0)=0 f 0 ( 0 ) = 0 x ≠ 0 x\neq 0 x = 0 f 0 ( x ) = + ∞ f_0(x)=+\infty f 0 ( x ) = + ∞ f n ( 0 ) f_n(0) f n ( 0 )
将函数 f i − 1 ( x ) f_{i-1}(x) f i − 1 ( x ) f i ( x ) f_i(x) f i ( x )
首先,加上 ∣ x ∣ Z |x|Z ∣ x ∣ Z f i − 1 ( x ) + ∣ x ∣ Z f_{i-1}(x)+|x|Z f i − 1 ( x ) + ∣ x ∣ Z
然后,与 h ( x ) h(x) h ( x ) min y ∈ R f i − 1 ( y ) + ∣ y ∣ Z + h ( x − y ) \min_{y\in\mathbf R}f_{i-1}(y)+|y|Z+h(x-y) min y ∈ R f i − 1 ( y ) + ∣ y ∣ Z + h ( x − y )
最后,将函数向左平移 ( b i − a i ) (b_i-a_i) ( b i − a i )
转化为对斜率段的操作,同样分为三步:
将原点左侧斜率段全体加上 − Z -Z − Z Z Z Z
将所有小于 − Y -Y − Y − Y -Y − Y X X X X X X
将所有斜率段向左平移 ( b i − a i ) (b_i-a_i) ( b i − a i )
原题中 a i a_i a i b i b_i b i 1 1 1 X X X − Y -Y − Y
对左右两个栈分别打懒标记,左侧加 − Z -Z − Z Z Z Z
每次栈内弹出元素时,都对 − Y -Y − Y X X X − Y -Y − Y X X X
将左栈顶部的 ( b i − a i ) (b_i-a_i) ( b i − a i ) b i − a i < 0 b_i-a_i<0 b i − a i < 0
在交换栈顶时,更新答案,向左移动就减去当前斜率,向右移动就加上当前斜率.
算法复杂度为 O ( n max { a i , b i } ) O(n\max\{a_i,b_i\}) O ( n max { a i , b i })
#include <iostream>
#include <stack>
int main () int n;
long long x, y, z;
std::cin >> n >> x >> y >> z;
std::stack<long long > neg, pos;
long long lt = 0 , rt = 0 ;
long long res = 0 ;
for (; n; --n) {
int a, b;
std::cin >> a >> b;
lt -= z;
rt += z;
for (; b < a; ++b) {
auto l = -y;
if (!neg.empty ()) {
l = std::max (l, neg.top () + lt);
neg.pop ();
}
pos.emplace (l - rt);
res -= l;
}
for (; b > a; --b) {
auto r = x;
if (!pos.empty ()) {
r = std::min (r, pos.top () + rt);
pos.pop ();
}
neg.emplace (r - lt);
res += r;
}
}
std::cout << res << std::endl;
return 0 ;
}
模板题:
习题
本文的最后,提供一些各类算法竞赛中出现过的且可以使用 Slope Trick 解决的问题,以供练习.
参考文献与注释