提醒
本页面要介绍的不是 计数排序.
本页面将简要介绍基数排序.
定义
基数排序(英语:Radix sort)是一种非比较型的排序算法,最早用于解决卡片排序的问题.基数排序将待排序的元素拆分为 个关键字,逐一对各个关键字排序后完成对所有元素的排序.
如果是从第 关键字到第 关键字顺序进行比较,则该基数排序称为 MSD(Most Significant Digit first)基数排序;
如果是从第 关键字到第 关键字顺序进行比较,则该基数排序称为 LSD(Least Significant Digit first)基数排序.
k - 关键字元素的比较
下面用 表示元素 的第 关键字.
假如元素有 个关键字,对于两个元素 和 ,默认的比较方法是:
- 比较两个元素的第 关键字 和 ,如果 则 ,如果 则 ,如果 则进行下一步;
- 比较两个元素的第 关键字 和 ,如果 则 ,如果 则 ,如果 则进行下一步;
- ……
- 比较两个元素的第 关键字 和 ,如果 则 ,如果 则 ,如果 则 .
例子:
- 如果对自然数进行比较,将自然数按个位对齐后往高位补齐 ,则一个数字从左往右数第 位数就可以作为第 关键字;
- 如果对字符串基于字典序进行比较,一个字符串从左往右数第 个字符就可以作为第 关键字;
- C++ 自带的
std::pair与std::tuple的默认比较方法与上述的相同.
MSD 基数排序
基于 k - 关键字元素的比较方法,可以想到:先比较所有元素的第 关键字,就可以确定出各元素大致的大小关系;然后对 具有相同第 关键字的元素,再比较它们的第 关键字……以此类推.
由于是从第 关键字到第 关键字顺序进行比较,由上述思想导出的排序算法称为 MSD(Most Significant Digit first)基数排序.
算法流程
将待排序的元素拆分为 个关键字,先对第 关键字进行稳定排序,然后对于每组 具有相同关键字的元素 再对第 关键字进行稳定排序(递归执行)……最后对于每组 具有相同关键字的元素 再对第 关键字进行稳定排序.
一般而言,我们默认基数排序是稳定的,所以在 MSD 基数排序中,我们也仅仅考虑借助 稳定算法(通常使用计数排序)完成内层对关键字的排序.
正确性参考上文 k - 关键字元素的比较.
参考代码
对自然数排序
下面是使用迭代式 MSD 基数排序对 unsigned int 范围内元素进行排序的 C++ 参考代码,可调整 和 的值(建议将 设为 以便位运算优化).
参考代码
constexpr unsigned MAXN = 1000;  // 要排序的数的个数
constexpr unsigned RADIX = 10;   // 基数
constexpr unsigned powRADIX[10] = {1,         10,        100,     1000,
                                   10000,     100000,    1000000, 10000000,
                                   100000000, 1000000000};  // RADIX 的幂

unsigned get_digit(unsigned value, int digit)  // 提取第 digit 位
{
  return (value / powRADIX[digit]) % RADIX;
}

void MSD_radix_sort(unsigned* begin, unsigned* end, int digit)
// 表示现在 [begin,end) 内的元素(10 进制下)前若干位都相同
// 只有最后 digit 位(第 digit-1 到 0 位)需要进行排序
// 调用示例:MSD_radix_sort(a,a+n,9)
{
  if (begin >= end)  // 空区间
  {
    return;
  }
  /**计数排序(个人写法仅供参考)**/
  static unsigned cnt[RADIX + 1],
      tmp[MAXN + 5];  // 由于不同层递归不会同时使用 cnt,tmp
                      // 数组(每层使用完毕才会调用下一层),使用 static
                      // 关键字可以节省空间
  vector<unsigned> beg;
  beg.resize(RADIX + 1);  // 对 beg 的访问可能冲突,使用局部变量
  for (int i = 0; i <= RADIX; i++) {
    cnt[i] = beg[i] = 0;  // 清空是一个好习惯
  }
  for (unsigned* it = begin; it != end; it++)  // 计数
  {
    int bitVal = get_digit(*it, digit - 1);
    cnt[bitVal] += 1;
  }
  beg[0] = 0;  // 计算每个数码开始存储的位置(偏移量)
  for (int i = 1; i <= RADIX; i++) {
    beg[i] = beg[i - 1] + cnt[i - 1];
  }
  // 多计算 beg[RADIX] 是因为这样可以直接定义 i 对应的范围是 [beg[i],beg[i+1])
  // 而不用担心那个 beg[i+1] 越界
  for (int i = 0; i < RADIX; i++) {
    cnt[i] = 0;
  }
  for (unsigned* it = begin; it != end; it++)  // 将计数排序结果放入 tmp
  {
    unsigned bitVal = get_digit(*it, digit - 1);  // 提取第 bit-1 位
    tmp[beg[bitVal] + cnt[bitVal]] =
        *it;  // 因为是倒序枚举,所以当前是第 cnt[bitVal]+1 个第 bit-1 位是
              // cnt[bitVal] 的
    cnt[bitVal]++;
  }
  for (unsigned* it = begin; it != end; it++)  // 将 tmp 拷贝回原数组
  {
    *it = tmp[it - begin];
  }
  /**迭代计算**/
  if (digit == 1)  // 已经是最低位
  {
    return;
  }
  for (int i = 0; i < RADIX; i++)  // 递归排序下一位
  {
    MSD_radix_sort(begin + beg[i], begin + beg[i + 1], digit - 1);
  }
}
对字符串排序
下面是使用迭代式 MSD 基数排序对 空终止字节字符串 基于字典序进行排序的 C++ 参考代码:
参考代码
constexpr int MAXN = 1000;

int get_digit(string* arr, int i, int dig) {
  if (arr[i][dig] == '\0') return 0;
  return arr[i][dig] - 'a' + 1;
}

void MSD_radix_sort_string_base(string* arr, int* begin, int* end,
                                int digit)  // 主体函数
// 对仅由小写字母构成的字符串排序
// 参数表示现在 [begin,end) 内的元素 [0,digit) 位都相同
// 现在从 digit 位开始进行排序
// 调用示例:MSD_radix_sort_string(a,a+n,0)
// 和上一份代码几乎完全相同,所以注释较少
// 为节省空间和时间,我们对下标数组进行排序,比较函数依旧比较字符串对应位
{
  if (begin >= end) return;
  static int tmp[MAXN + 5];
  static int cnt[28];
  vector<int> beg;
  beg.resize(28);
  // Q: 为什么开 28?
  // A: 0=空字符,1-26=a-z,27=额外空间(防止越界)
  for (int i = 0; i < 28; i++) cnt[i] = beg[i] = 0;
  for (int* it = begin; it != end; it++) cnt[get_digit(arr, *it, digit)] += 1;
  beg[0] = 0;
  for (int i = 1; i <= 27; i++) beg[i] = beg[i - 1] + cnt[i - 1];
  for (int i = 0; i < 28; i++) cnt[i] = 0;
  for (int* it = begin; it != end; it++) {
    int bitVal = get_digit(arr, *it, digit);
    tmp[beg[bitVal] + cnt[bitVal]] = *it;
    cnt[bitVal]++;
  }
  for (int* it = begin; it != end; it++) *it = tmp[it - begin];
  // 如果已经是空字符了就没必要递归了,所以递归 1~26
  for (int i = 1; i <= 26; i++)
    MSD_radix_sort_string_base(arr, begin + beg[i], begin + beg[i + 1],
                               digit + 1);
}

int label[MAXN + 5];

void MSD_radix_sort_string(string* begin, string* end)  // 调用接口
{
  static string tmp[MAXN + 5];
  int n = end - begin;
  for (int i = 0; i < n; i++) {
    label[i] = i;
    tmp[i] = *(begin + i);
  }
  MSD_radix_sort_string_base(tmp, label, label + n, 0);
  for (int i = 0; i < n; i++) {
    *(begin + i) = tmp[label[i]];
  }
}
由于两个字符串的比较很容易冲上 的线性复杂度,因此在字符串排序这件事情上,MSD 基数排序比大多数基于比较的排序算法在时间复杂度和实际用时上都更加优秀.
与桶排序的关系
前置知识:桶排序
桶排序需要其它的排序算法来完成对每个桶内部元素的排序.但实际上,完全可以对每个桶继续执行桶排序,直至某一步桶的元素数量 .
因此 MSD 基数排序的另一种理解方式是:使用桶排序实现的桶排序.
也因此,可以提出 MSD 基数排序在时间常数上的一种优化方法:假如到某一步桶的元素数量 ( 是自己选的常数),则直接执行插入排序然后返回,降低递归次数.
LSD 基数排序
MSD 基数排序从第 关键字到第 关键字顺序进行比较,为此需要借助递归或迭代来实现,时间常数还是较大,而且在比较自然数上还是略显不便.
而将递归的操作反过来:从第 关键字到第 关键字顺序进行比较,就可以得到 LSD(Least Significant Digit first)基数排序,不使用递归就可以完成的排序算法.
算法流程
将待排序的元素拆分为 个关键字,然后先对 所有元素 的第 关键字进行稳定排序,再对 所有元素 的第 关键字进行稳定排序,再对 所有元素 的第 关键字进行稳定排序……最后对 所有元素 的第 关键字进行稳定排序,这样就完成了对整个待排序序列的稳定排序.
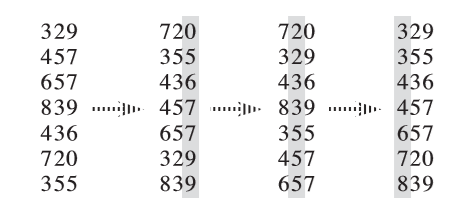
LSD 基数排序也需要借助一种 稳定算法 完成内层对关键字的排序.同样的,通常使用计数排序来完成.
LSD 基数排序的正确性可以参考 《算法导论(第三版)》第 8.3-3 题的解法 或参考下面的解释:
正确性
回顾一下 k - 关键字元素的比较方法,
- 假如想通过 和 就比较出两个元素 和 的大小,则需要提前知道通过比较 和 得到的结论,以便于应对 的情况;
- 而想通过 和 就比较出两个元素 和 的大小,则需要提前知道通过比较 和 得到的结论,以便于应对 的情况;
- ……
- 而想通过 和 就比较出两个元素 和 的大小,则需要提前知道通过比较 和 得到的结论,以便于应对 的情况;
- 和 可以直接比较.
现在,将顺序反过来:
- 和 可以直接比较;
- 而知道通过比较 和 得到的结论后,就可以得到比较 和 的结论;
- ……
- 而知道通过比较 和 得到的结论后,就可以得到比较 和 的结论;
- 而知道通过比较 和 得到的结论后,就最终得到了比较 和 的结论.
在这个过程中,对每个关键字边比较边重排元素的顺序,就得到了 LSD 基数排序.
伪代码
参考代码
下面是使用 LSD 基数排序实现的对 k - 关键字元素的排序.
参考代码
constexpr int N = 100010;
constexpr int W = 100010;
constexpr int K = 100;

int n, w, k, cnt[W];

struct Element {
  int key[K];
} a[N], b[N];

void counting_sort(int p) {
  memset(cnt, 0, sizeof(cnt));
  for (int i = 1; i <= n; ++i) ++cnt[a[i].key[p]];
  for (int i = 1; i <= w; ++i) cnt[i] += cnt[i - 1];
  // 为保证排序的稳定性,此处循环i应从n到1
  // 即当两元素关键字的值相同时,原先排在后面的元素在排序后仍应排在后面
  for (int i = n; i >= 1; --i) b[cnt[a[i].key[p]]--] = a[i];
  memcpy(a, b, sizeof(a));
}

void radix_sort() {
  for (int i = k; i >= 1; --i) {
    // 借助计数排序完成对关键字的排序
    counting_sort(i);
  }
}
实际上并非必须从后往前枚举才是稳定排序,只需对 cnt 数组进行等价于 std::exclusive_scan 的操作即可.
例题 洛谷 P1177【模板】排序
给出 个正整数,从小到大输出.
#include <algorithm>
#include <iostream>
#include <utility>

void radix_sort(int n, int a[]) {
  int *b = new int[n];  // 临时空间
  int *cnt = new int[1 << 8];
  int mask = (1 << 8) - 1;
  int *x = a, *y = b;
  for (int i = 0; i < 32; i += 8) {
    for (int j = 0; j != (1 << 8); ++j) cnt[j] = 0;
    for (int j = 0; j != n; ++j) ++cnt[x[j] >> i & mask];
    for (int sum = 0, j = 0; j != (1 << 8); ++j) {
      // 等价于 std::exclusive_scan(cnt, cnt + (1 << 8), cnt, 0);
      sum += cnt[j], cnt[j] = sum - cnt[j];
    }
    for (int j = 0; j != n; ++j) y[cnt[x[j] >> i & mask]++] = x[j];
    std::swap(x, y);
  }
  delete[] cnt;
  delete[] b;
}

int main() {
  std::ios::sync_with_stdio(false);
  std::cin.tie(nullptr);
  int n;
  std::cin >> n;
  int *a = new int[n];
  for (int i = 0; i < n; ++i) std::cin >> a[i];
  radix_sort(n, a);
  for (int i = 0; i < n; ++i) std::cout << a[i] << ' ';
  delete[] a;
  return 0;
}
性质
稳定性
如果对内层关键字的排序是稳定的,则 MSD 基数排序和 LSD 基数排序都是稳定的排序算法.
时间复杂度
通常而言,基数排序比基于比较的排序算法(比如快速排序)要快.但由于需要额外的内存空间,因此当内存空间稀缺时,原地置换算法(比如快速排序)或许是个更好的选择.1
一般来说,如果每个关键字的值域都不大,就可以使用 计数排序 作为内层排序,此时的复杂度为 ,其中 为第 关键字的值域大小.如果关键字值域很大,就可以直接使用基于比较的 排序而无需使用基数排序了.
空间复杂度
MSD 基数排序和 LSD 基数排序的空间复杂度都为 .
参考资料与注释
Footnotes
-
Thomas H. Cormen, Charles E. Leiserson, Ronald L. Rivest, and Clifford Stein.Introduction to Algorithms(3rd ed.). MIT Press and McGraw-Hill, 2009. ISBN 978-0-262-03384-8. "8.3 Radix sort", pp. 199. ↩