引入
前缀和与差分是算法竞赛中常用的技巧,前者用于快速求区间和,后者用于高效进行区间修改.
规定
为方便讨论,本文默认数组 下标从 开始,并补充定义 .
前缀和
前缀和可以简单理解为「数列的前 项的和」,是一种重要的预处理方式.
一维前缀和
对于长度为 的序列 ,如果要多次查询区间 中序列数字的和,就可以考虑使用前缀和.序列的前缀和就是
它可以通过递推关系式
逐项计算得到.要询问区间 内的序列的和,只需要计算差值
就这样,通过 时间预处理,能够将单次查询区间和的复杂度降低到 .
参考实现
C++
int n;                // Array size.
std::vector<int> a;   // Array. (indexed from 1)
std::vector<int> ps;  // Prefix sum array.

// Calculate prefix sum.
void prefix_sum() {
  ps = a;
  // Or simply:
  // std::partial_sum(a.begin(), a.end(), ps.begin());
  for (int i = 1; i <= n; ++i) {
    ps[i] += ps[i - 1];
  }
}

// Query sum of elements in [l, r].
int query(int l, int r) { return ps[r] - ps[l - 1]; }
Python
n = 0  # Array size
a = []  # Array (indexed from 1)
ps = []  # Prefix sum array


# Calculate prefix sum
def prefix_sum():
    global ps
    ps = a[:]
    # Or simply:
    # ps = list(itertools.accumulate(a))
    for i in range(1, n + 1):
        ps[i] += ps[i - 1]


# Query sum of elements in [l, r]
def query(l, r):
    return ps[r] - ps[l - 1]
C++ 标准库中实现了前缀和函数 std::partial_sum,定义于头文件 <numeric> 中.从 C++17 开始,标准库还提供了一个功能相同的前缀和函数 std::inclusive_scan,同样定义于头文件 <numeric> 中.
二维/多维前缀和
将一维前缀和拓展到多维的情形,就是多维前缀和.常见的多维前缀和的求解方法有两种.
基于容斥原理
这种方法多用于二维前缀和的情形.给定大小为 的二维数组 ,要求出其前缀和 .那么, 同样是大小为 的二维数组,且
类比一维的情形, 应该可以基于 或 计算,从而避免重复计算前面若干项的和.但是,如果直接将 和 相加,再加上 ,会导致重复计算 这一重叠部分的前缀和,所以还需要再将这部分减掉.这就是 容斥原理.由此得到如下递推关系:
实现时,直接遍历 求和即可.
示例
考虑一个具体的例子.
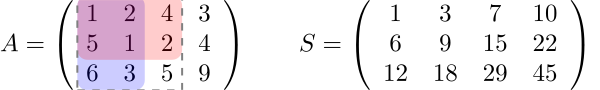
其中, 是矩阵 的前缀和.根据定义, 是左图中虚线方框中的子矩阵的和.而且, 是蓝色子矩阵的和, 是红色子矩阵的和,它们重叠部分的和是 .由此可见,如果直接相加 和 ,会重复计算 ,所以应该有
同样的道理,在已经预处理出二维前缀和后,要查询左上角为 、右下角为 的子矩阵的和,可以计算
这可以在 时间内完成.
在二维的情形,以上算法的时间复杂度可以简单认为是 ,即与给定数组的大小成线性关系.但是,当维度 增大时,由于容斥原理涉及的项数以指数级的速度增长,时间复杂度会成为 ,其中 是数组维度,而 是给定数组大小.因此,该算法不再适用.
洛谷 P1387 最大正方形
在一个 的只包含 和 的矩阵里找出一个不包含 的最大正方形,输出边长.
参考代码
C++
#include <algorithm>
#include <iostream>
#include <vector>

// --8<-- [start:core]
int n, m;
std::vector<std::vector<int>> a, ps;  // (n + 1) x (m + 1).

// Calculate the prefix sum of 2-d array.
void prefix_sum() {
  ps = a;
  for (int i = 1; i <= n; ++i)
    for (int j = 1; j <= m; ++j)
      ps[i][j] += ps[i - 1][j] + ps[i][j - 1] - ps[i - 1][j - 1];
}

// Find the sum of elements in submatrix [x1, y1] to [x2, y2].
int query(int x1, int y1, int x2, int y2) {
  return ps[x2][y2] - ps[x1 - 1][y2] - ps[x2][y1 - 1] + ps[x1 - 1][y1 - 1];
}

// --8<-- [end:core]
int main() {
  std::cin >> n >> m;
  a.assign(n + 1, std::vector<int>(m + 1));

  for (int i = 1; i <= n; i++)
    for (int j = 1; j <= m; j++) std::cin >> a[i][j];

  prefix_sum();

  int ans = 0;
  for (int l = 1; l <= std::min(n, m); ++l)
    for (int i = l; i <= n; i++)
      for (int j = l; j <= m; j++)
        if (query(i - l + 1, j - l + 1, i, j) == l * l) ans = std::max(ans, l);

  std::cout << ans << std::endl;
  return 0;
}
Python
# --8<-- [start:core]
n, m = 0, 0
a = []  # (n+1) x (m+1)
ps = []  # prefix sum array


# Calculate the prefix sum of 2D array.
def prefix_sum():
    global ps
    ps = [row[:] for row in a]  # Deep copy of a
    for i in range(1, n + 1):
        for j in range(1, m + 1):
            ps[i][j] += ps[i - 1][j] + ps[i][j - 1] - ps[i - 1][j - 1]


# Find the sum of elements in submatrix [x1, y1] to [x2, y2].
def query(x1, y1, x2, y2):
    return ps[x2][y2] - ps[x1 - 1][y2] - ps[x2][y1 - 1] + ps[x1 - 1][y1 - 1]


# --8<-- [end:core]
if __name__ == "__main__":
    n, m = map(int, input().split())

    # Initialize with zero padding for 1-based indexing
    a = [[0] * (m + 1)]
    for _ in range(n):
        row = list(map(int, input().split()))
        a.append([0] + row)

    prefix_sum()
    ans = 0

    for l in range(1, min(n, m) + 1):
        for i in range(l, n + 1):
            for j in range(l, m + 1):
                if query(i - l + 1, j - l + 1, i, j) == l * l:
                    ans = max(ans, l)

    print(ans)
逐维前缀和
对于一般的情形,给定 维数组 ,大小为 ,同样要求得其前缀和 .这里,
从上式可以看出, 维前缀和就等于 次求和.所以,一个显然的算法是,每次只考虑一个维度,固定所有其它维度,然后求若干个一维前缀和,这样对所有 个维度分别求和之后,得到的就是 维前缀和.
三维前缀和的参考实现
int N1, N2, N3;
std::vector<std::vector<std::vector<int>>> a,
    ps;  // (N1 + 1) x (N2 + 1) x (N3 + 1).

// Calculate prefix sum of 3d array.
void prefix_sum() {
  ps = a;

  // Prefix-sum for 3rd dimension.
  for (int i = 1; i <= N1; ++i)
    for (int j = 1; j <= N2; ++j)
      for (int k = 1; k <= N3; ++k) ps[i][j][k] += ps[i][j][k - 1];

  // Prefix-sum for 2nd dimension.
  for (int i = 1; i <= N1; ++i)
    for (int j = 1; j <= N2; ++j)
      for (int k = 1; k <= N3; ++k) ps[i][j][k] += ps[i][j - 1][k];

  // Prefix-sum for 1st dimension.
  for (int i = 1; i <= N1; ++i)
    for (int j = 1; j <= N2; ++j)
      for (int k = 1; k <= N3; ++k) ps[i][j][k] += ps[i - 1][j][k];
}
因为考虑每一个维度的时候,都只遍历了整个数组一遍,这样的算法复杂度是 的,通常可以接受.
特例:子集和 DP
维度比较大的情形,经常出现在一类叫做 子集和(sum over subsets, SOS)的问题中.这是高维前缀和的特例.
问题描述如下.考虑大小为 的集合的全体子集上面定义的函数 ,现在要求出其子集和函数 ,它满足
即 等于其所有子集 上的函数值 的和.
首先,子集和问题可以写成高维前缀和的形式.注意到, 的子集可以通过状态压缩的思想表示为长度为 的 0-1 字符串 .将字符串的每一位都看作是数组下标的一个维度,那么 其实就是一个 维数组,且每个维度下标都一定在 中.同时,子集的包含关系就等价于下标的大小关系,即
所以,对子集求和,就是求这个 维数组的前缀和.
现在,可以直接使用前文所述的逐维前缀和的方法求得子集和.时间复杂度是 .
参考实现
int n;
std::vector<int> a, ps;  // length = 1 << n.

void sum_of_subsets() {
  ps = a;
  // Loop over dimensions.
  for (int i = 0; i < n; ++i) {
    // Loop over i-th dimension.
    for (int st = 0; st < (1 << n); ++st) {
      // This condition implies that i-th dimension is 1.
      if ((st >> i) & 1) {
        // ps[... 1 ...] += ps[... 0 ...]. (i-th dimension)
        ps[st] += ps[st ^ (1 << i)];
      }
    }
  }
}
子集和的逆操作需要通过 容斥原理 进行.子集和问题也是快速莫比乌斯变换的必要步骤之一.
树上前缀和
一维前缀和还可以推广到有根树(树根为 )的情形.通过预处理前缀和,可以快速求解树上一段路径的权值和.
点权的情形
首先讨论权值存储在结点处的情形.设结点 处有权值 .可以通过递推关系
求出从根结点到结点 的路径上的结点的权值和,其中, 表示 的父结点.预处理完前缀和后,就可以通过
计算连接结点 和 的路径上的结点权值和.其中, 表示结点 与 的 最近公共祖先.
边权的情形
权值储存在边上的情形几乎可以转化为点权的情形.对于所有非根结点 ,记 表示连接结点 和它的父结点 的边.那么,可以假设边权存储在离根远的结点上.也就是说,结点 处存储的是边 上的边权.根结点处存储的权值是 .那么,通过上一小节讨论过的递推关系,同样可以预处理出根结点到结点 的路径经过的所有边的权值和 .
此时,连接结点 和 的路径上的结点权值和可以通过
进行查询.注意与点权的情形不同,所查询的权值和不包括 处的权值,因为它存储的边权不在所求路径中.
子树和
和数组的情形不同,由于树的首尾不对称,所以自下而上(从树叶到树根)和自上而下(从树根到树叶)求「前缀和」得到的结果并不相同.一般情况下,「树上前缀和」指的是自上而下计算的前缀和.为方便讨论,本文将自下而上计算的「前缀和」称为 子树和.
以结点 为根的子树的点权权值和,即相应的子树和,就是
其中, 表示 的所有子孙结点(包括其自身)的集合.
与树上前缀和不同,子树和并不能应用于 求路径权值和,但是它可以用于理解下文的树上差分.
差分
差分是一种与前缀和相对的策略,是前缀和的逆运算.相较于给定某一序列求它的差分,竞赛中更为常见的情景是,通过维护差分序列的信息,实现多次区间修改.在区间修改结束后,可以通过前缀和恢复原序列的信息,实现对原序列的查询.注意修改操作一定要在查询操作之前.
如果需要支持多次修改和查询的混合操作,需要使用 树状数组,但是它们的思想是共通的.
一维差分
对于序列 ,它的差分序列 是指
C++ 标准库中实现了差分函数 std::adjacent_difference,定义于头文件 <numeric> 中.
前缀和与差分的关系如下:
性质
设 是 的差分序列,那么,有
-
序列 是序列 的前缀和,即
-
序列 的前缀和为
差分信息常常用于维护多次对序列的一个区间加上一个数,并在之后一次或多次询问序列某一位的取值.
假设要将序列 在区间 中的每个数都加上一个 .可以在它的差分序列 上做如下操作:
在所有修改操作结束后,可以通过前缀和操作恢复更新后的 的值.单次修改是 的.查询时,需要做一次 的前缀和操作,随后每次查询都是 的.
参考代码
int n;
std::vector<int> diff, a;

// Add v to each element in [l, r].
void add(int l, int r, int v) {
  diff[l] += v;
  if (r < n) diff[r + 1] -= v;
}

// Execute this after all modifications and before all queries.
void prefix_sum() {
  for (int i = 1; i <= n; ++i) a[i] = a[i - 1] + diff[i];
}
二维/多维差分
差分同样可以推广到多维的情形.将多维差分看作多维前缀和的逆运算,那么,求多维差分数组的操作就相当于根据多维前缀和求它的原数组.根据前文讨论,可以利用容斥原理.例如,二维差分的定义是
但是,如果要计算整个差分数组,更为简单高效的做法是逐维差分,即穷举所有维度,沿着每个维度都计算一遍数组的差分.
二维差分信息常用于维护二维数组的多次矩形加.例如,要对左上角为 、右下角为 的矩阵中的每个数字都加上 ,可以对它的差分数组 做如下操作:
在所有修改操作结束后,只需要执行一遍二维前缀和,就可以快速查询更新后的数组的值.
参考代码
int n, m;
std::vector<std::vector<int>> diff, a;

// Add v to each element from [x1, y1] to [x2, y2].
void add(int x1, int y1, int x2, int y2, int v) {
  diff[x1][y1] += v;
  if (x2 < n) diff[x2 + 1][y1] -= v;
  if (y2 < m) diff[x1][y2 + 1] -= v;
  if (x2 < n && y2 < m) diff[x2 + 1][y2 + 1] += v;
}

// Execute this after all modifications and before all queries.
void prefix_sum() {
  a = diff;

  for (int i = 1; i <= n; ++i)
    for (int j = 1; j <= m; ++j) a[i][j] += a[i - 1][j];

  for (int i = 1; i <= n; ++i)
    for (int j = 1; j <= m; ++j) a[i][j] += a[i][j - 1];
}
当然,类似的想法对于维度 也成立,但是单次修改操作需要的时间复杂度为 ,随着 增大而不再实用.
树上差分
差分可以推广到有根树的情形,用于实现树上一段路径的区间加操作.取决于维护的信息存储在结点上还是边上,树上差分可以分为 点差分 与 边差分,在实现上会稍有不同.另外,相对于树上前缀和操作,更常用的是在所有修改操作后做子树和再查询.本节讨论的就是这种情形.
点差分
如果要对结点 和 之间的路径上的所有点权都加 ,可以对它的差分序列 做如下操作:
在所有修改操作完成后,可以计算一次子树和,就能得到更新后的点权.
示例
对结点 和 之间的路径上的点权做区间加操作时,上述公式中的前两条是对蓝色方框内的路径进行一维差分操作,后两条是对红色方框内的路径进行一维差分操作:
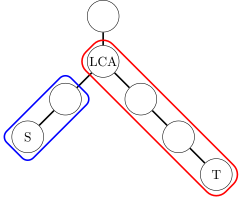
自下而上求和,就相当于对这两个区间从下向上计算前缀和.由此,对比上文的一维差分操作,就能知道点差分操作的正确性.
边差分
如果要对结点 和 之间的路径上的所有边权都加 ,可以对它的差分序列 做如下操作:
在所有修改操作完成后,可以计算一次子树和,就能得到更新后的点权.
示例
如图所示,边差分操作可以用于解决红色路径上的边权区间加问题.
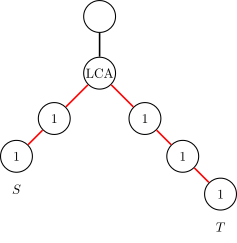
由于在边上直接进行差分比较困难,所以将本来应当累加到红色边上的值向下移动到相邻的结点里,操作起来就方便了.对比点差分的公式,就可以理解边差分的公式.
例题
洛谷 3128 最大流
FJ 给他的牛棚的 个隔间之间安装了 根管道,隔间编号从 到 .所有隔间都被管道连通了.
FJ 有 条运输牛奶的路线,第 条路线从隔间 运输到隔间 .一条运输路线会给它的两个端点处的隔间以及中间途径的所有隔间带来一个单位的运输压力,你需要计算压力最大的隔间的压力是多少.
解题思路
需要统计每个点经过了多少次,那么就用树上差分将每一次的路径上的点加一,可以很快得到每个点经过的次数.这里采用倍增法计算 LCA,最后对 DFS 遍历整棵树,在回溯时对差分数组求和就能求得答案了.
参考代码
#include <algorithm>
#include <iostream>
using namespace std;

constexpr int MAXN = 50010;

struct node {
  int to, next;
} edge[MAXN << 1];

int fa[MAXN][30], head[MAXN << 1];
int power[MAXN];
int depth[MAXN], lg[MAXN];
int n, k, ans = 0, tot = 0;

void add(int x, int y) {  // 加边
  edge[++tot].to = y;
  edge[tot].next = head[x];
  head[x] = tot;
}

void dfs(int now, int father) {  // dfs求最大压力
  fa[now][0] = father;
  depth[now] = depth[father] + 1;
  for (int i = 1; i <= lg[depth[now]]; ++i)
    fa[now][i] = fa[fa[now][i - 1]][i - 1];
  for (int i = head[now]; i; i = edge[i].next)
    if (edge[i].to != father) dfs(edge[i].to, now);
}

int lca(int x, int y) {  // 求LCA,最近公共祖先
  if (depth[x] < depth[y]) swap(x, y);
  while (depth[x] > depth[y]) x = fa[x][lg[depth[x] - depth[y]] - 1];
  if (x == y) return x;
  for (int k = lg[depth[x]] - 1; k >= 0; k--) {
    if (fa[x][k] != fa[y][k]) x = fa[x][k], y = fa[y][k];
  }
  return fa[x][0];
}

// 用dfs求最大压力,回溯时将子树的权值加上
void get_ans(int u, int father) {
  for (int i = head[u]; i; i = edge[i].next) {
    int to = edge[i].to;
    if (to == father) continue;
    get_ans(to, u);
    power[u] += power[to];
  }
  ans = max(ans, power[u]);
}

int main() {
  cin.tie(nullptr)->sync_with_stdio(false);
  cin >> n >> k;
  int x, y;
  for (int i = 1; i <= n; i++) {
    lg[i] = lg[i - 1] + (1 << lg[i - 1] == i);
  }
  for (int i = 1; i <= n - 1; i++) {  // 建图
    cin >> x >> y;
    add(x, y);
    add(y, x);
  }
  dfs(1, 0);
  int s, t;
  for (int i = 1; i <= k; i++) {
    cin >> s >> t;
    int ancestor = lca(s, t);
    // 树上差分
    power[s]++;
    power[t]++;
    power[ancestor]--;
    power[fa[ancestor][0]]--;
  }
  get_ans(1, 0);
  cout << ans << '\n';
  return 0;
}
习题
前缀和:
- 洛谷 B3612【深进 1. 例 1】求区间和
- 洛谷 U69096 前缀和的逆
- AtCoder joi2007ho_a 最大の和
- 「USACO16JAN」子共七 Subsequences Summing to Sevens
- 「USACO05JAN」Moo Volume S
二维/多维前缀和:
- HDU 6514 Monitor
- 洛谷 P1387 最大正方形
- 「HNOI2003」激光炸弹
- CF 165E Compatible Numbers
- CF 383E Vowels
- ARC 100C Or Plus Max
树上前缀和:
差分:
二维/多维差分:
树上差分: